15 mejores herramientas de gestión del rendimiento de aplicaciones
Ryan Tanner
Especialista en Marketing de Producto
10 sep 2026
Ryan Tanner
10 sep 2026

15 min


Las aplicaciones modernas impulsan casi todas las interacciones con los clientes, los flujos de trabajo internos y los servicios digitales. A medida que los sistemas se vuelven más distribuidos y nativos en la nube, mantener un rendimiento constante se ha vuelto más desafiante que nunca. Incluso pequeñas ralentizaciones o interrupciones pueden afectar los ingresos, la satisfacción del cliente y la reputación de la marca.
Las herramientas de gestión del rendimiento de aplicaciones ayudan a las organizaciones a monitorear la confiabilidad, detectar problemas de forma temprana y comprender cómo se comporta el software en entornos reales. Las plataformas actuales van más allá del monitoreo técnico al conectar información con la respuesta a incidentes, la automatización y la colaboración entre equipos. Las soluciones están ampliando gradualmente este espacio al ayudar a los equipos a convertir la información sobre el rendimiento en acciones coordinadas entre departamentos. Esta guía explora las mejores herramientas de gestión del rendimiento de aplicaciones y cómo elegir la solución adecuada.
Conclusiones clave: 5 mejores soluciones para la gestión del rendimiento de aplicaciones
Las organizaciones que evalúan las mejores herramientas suelen comenzar con una lista corta de plataformas de confianza. Las siguientes soluciones representan diferentes enfoques para la observabilidad, la automatización y la colaboración.
1. Lark: Un espacio de trabajo todo en uno para rastrear y monitorear el rendimiento.
2. Datadog: Monitoreo nativo en la nube con análisis avanzados e integraciones sólidas.
3. New Relic: Observabilidad de pila completa para entornos modernos en la nube.
4. Dynatrace: Monitoreo impulsado por IA para entornos a escala empresarial.
5. AppDynamics: Monitoreo del rendimiento empresarial con rastreo profundo de transacciones.
Descripción general: comparación de 5 herramientas utilizadas en el monitoreo del rendimiento de aplicaciones
La siguiente comparación ofrece una visión general de las principales plataformas en modelos de implementación, capacidades de IA y detalles de planes gratuitos. Esta descripción ayuda a los equipos a comprender rápidamente cómo difieren las herramientas antes de explorar reseñas detalladas.
Fuente de información: sitios oficiales de los proveedores
Fecha de actualización: 17-02-2026
Nota: Los precios y detalles de los planes reflejan datos disponibles públicamente a la fecha de actualización y pueden variar según la región, el ciclo de facturación y el número de agentes.

¿Qué es el software de gestión del rendimiento de aplicaciones?
El software de gestión del rendimiento de aplicaciones proporciona herramientas para supervisar, analizar y optimizar el comportamiento de las aplicaciones en toda la infraestructura, los servicios y las experiencias de los usuarios. Estas plataformas recopilan datos de telemetría como métricas, registros y trazas para ayudar a los equipos a comprender cómo funcionan las aplicaciones en tiempo real. Muchas organizaciones dependen de herramientas de medición del rendimiento de aplicaciones para rastrear la latencia, las tasas de error y la experiencia del usuario en entornos distribuidos.
Las organizaciones dependen de herramientas de monitoreo del rendimiento de aplicaciones para detectar anomalías, resolver problemas y mantener la confiabilidad en sistemas distribuidos. Los entornos modernos suelen incluir microservicios, contenedores, API e integraciones de terceros, lo que hace imposible el monitoreo manual. Las plataformas de APM automatizan la visibilidad y ayudan a los equipos a mantener una calidad de servicio constante.
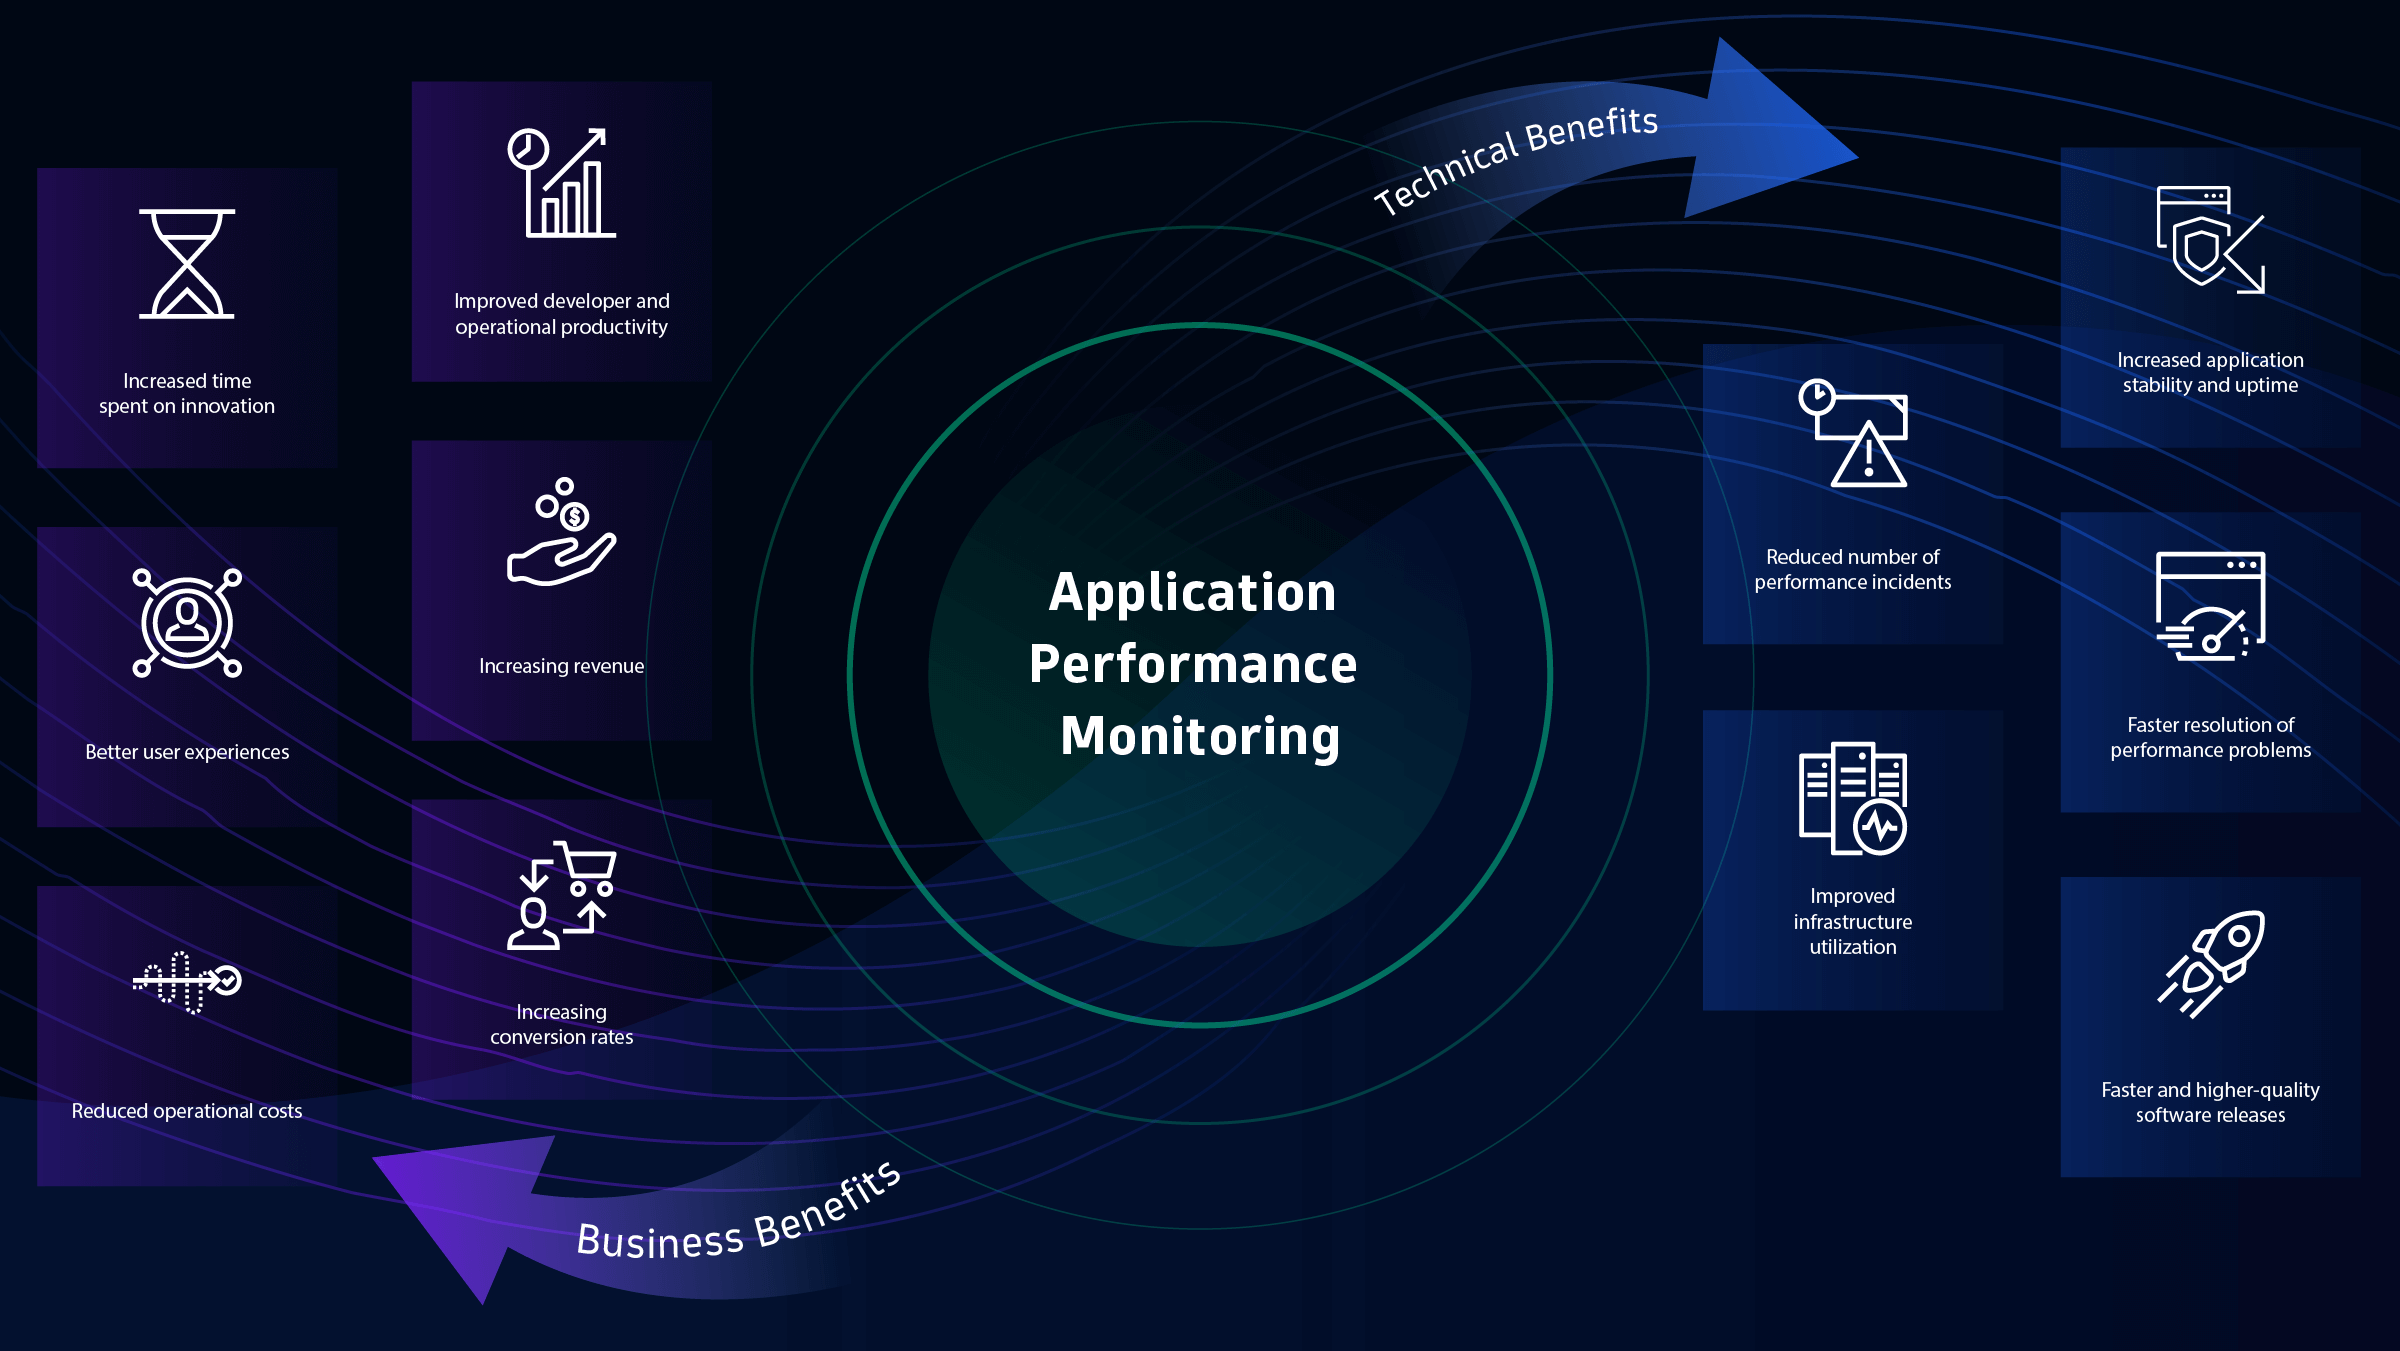
Más allá del monitoreo, los sistemas modernos de gestión del rendimiento de aplicaciones admiten la automatización, la colaboración y el análisis predictivo. Ayudan a los equipos a reducir el tiempo de inactividad, mejorar la experiencia digital y mantener la eficiencia de costos en entornos de nube.
Cómo evaluar las soluciones de gestión del rendimiento de aplicaciones en 2026
Elegir la plataforma adecuada requiere comprender las capacidades que más importan para la escalabilidad y confiabilidad a largo plazo.
- Profundidad de detección de anomalías con IA: Las plataformas deben detectar automáticamente comportamientos inusuales y reducir la fatiga por alertas. La IA avanzada mejora la precisión de la detección y acelera el análisis de la causa raíz. Una sólida detección de anomalías reduce el tiempo de inactividad y la resolución manual de problemas.
- Precisión del monitoreo de usuarios reales: El monitoreo de usuarios reales revela cómo los clientes experimentan las aplicaciones en tiempo real. Los datos precisos de RUM ayudan a los equipos a priorizar mejoras basadas en el impacto real. Las percepciones sobre la experiencia del usuario respaldan la optimización del rendimiento y la retención.
- Preparación para entornos nativos en la nube: Las aplicaciones modernas dependen de contenedores e infraestructura sin servidor. El monitoreo nativo en la nube garantiza visibilidad en sistemas distribuidos. Las herramientas deben admitir entornos híbridos y multinube.
- Previsibilidad de costos a gran escala: La tarificación basada en el uso puede crecer rápidamente a medida que aumenta el volumen de datos. Los equipos deben evaluar cuidadosamente la previsibilidad de costos a largo plazo. La tarificación transparente mejora la elaboración de presupuestos y la planificación.
- Capacidades de automatización y remediación: Flujos de trabajo automatizados ayudan a resolver problemas más rápido. La automatización de la remediación reduce la intervención manual y mejora los tiempos de respuesta. La automatización mejora la confiabilidad y la eficiencia operativa.
- Funciones de colaboración entre equipos: El monitoreo del rendimiento involucra a desarrolladores, operaciones y equipos de negocio. Herramientas de colaboración mejoran la comunicación y la respuesta a incidentes. La visibilidad compartida acelera la resolución de problemas.
- Madurez del ecosistema del proveedor: Los ecosistemas maduros ofrecen integración y soporte comunitario. La compatibilidad de integración garantiza flexibilidad a largo plazo. Los ecosistemas sólidos reducen los riesgos de migración.
Las 15 mejores herramientas para la gestión del rendimiento de aplicaciones
Los entornos de aplicaciones modernas requieren más que un monitoreo básico del tiempo de actividad. Los equipos necesitan una visibilidad profunda en toda la infraestructura, los servicios y las interacciones de los usuarios para mantener la confiabilidad a gran escala. Las siguientes herramientas representan soluciones líderes de gestión del rendimiento de aplicaciones utilizadas tanto por startups como por empresas consolidadas. Cada plataforma ofrece un enfoque distinto para el monitoreo, la observabilidad, la automatización y la coordinación entre equipos.
1. Lark: Un espacio de trabajo todo en uno para rastrear y monitorear el rendimiento
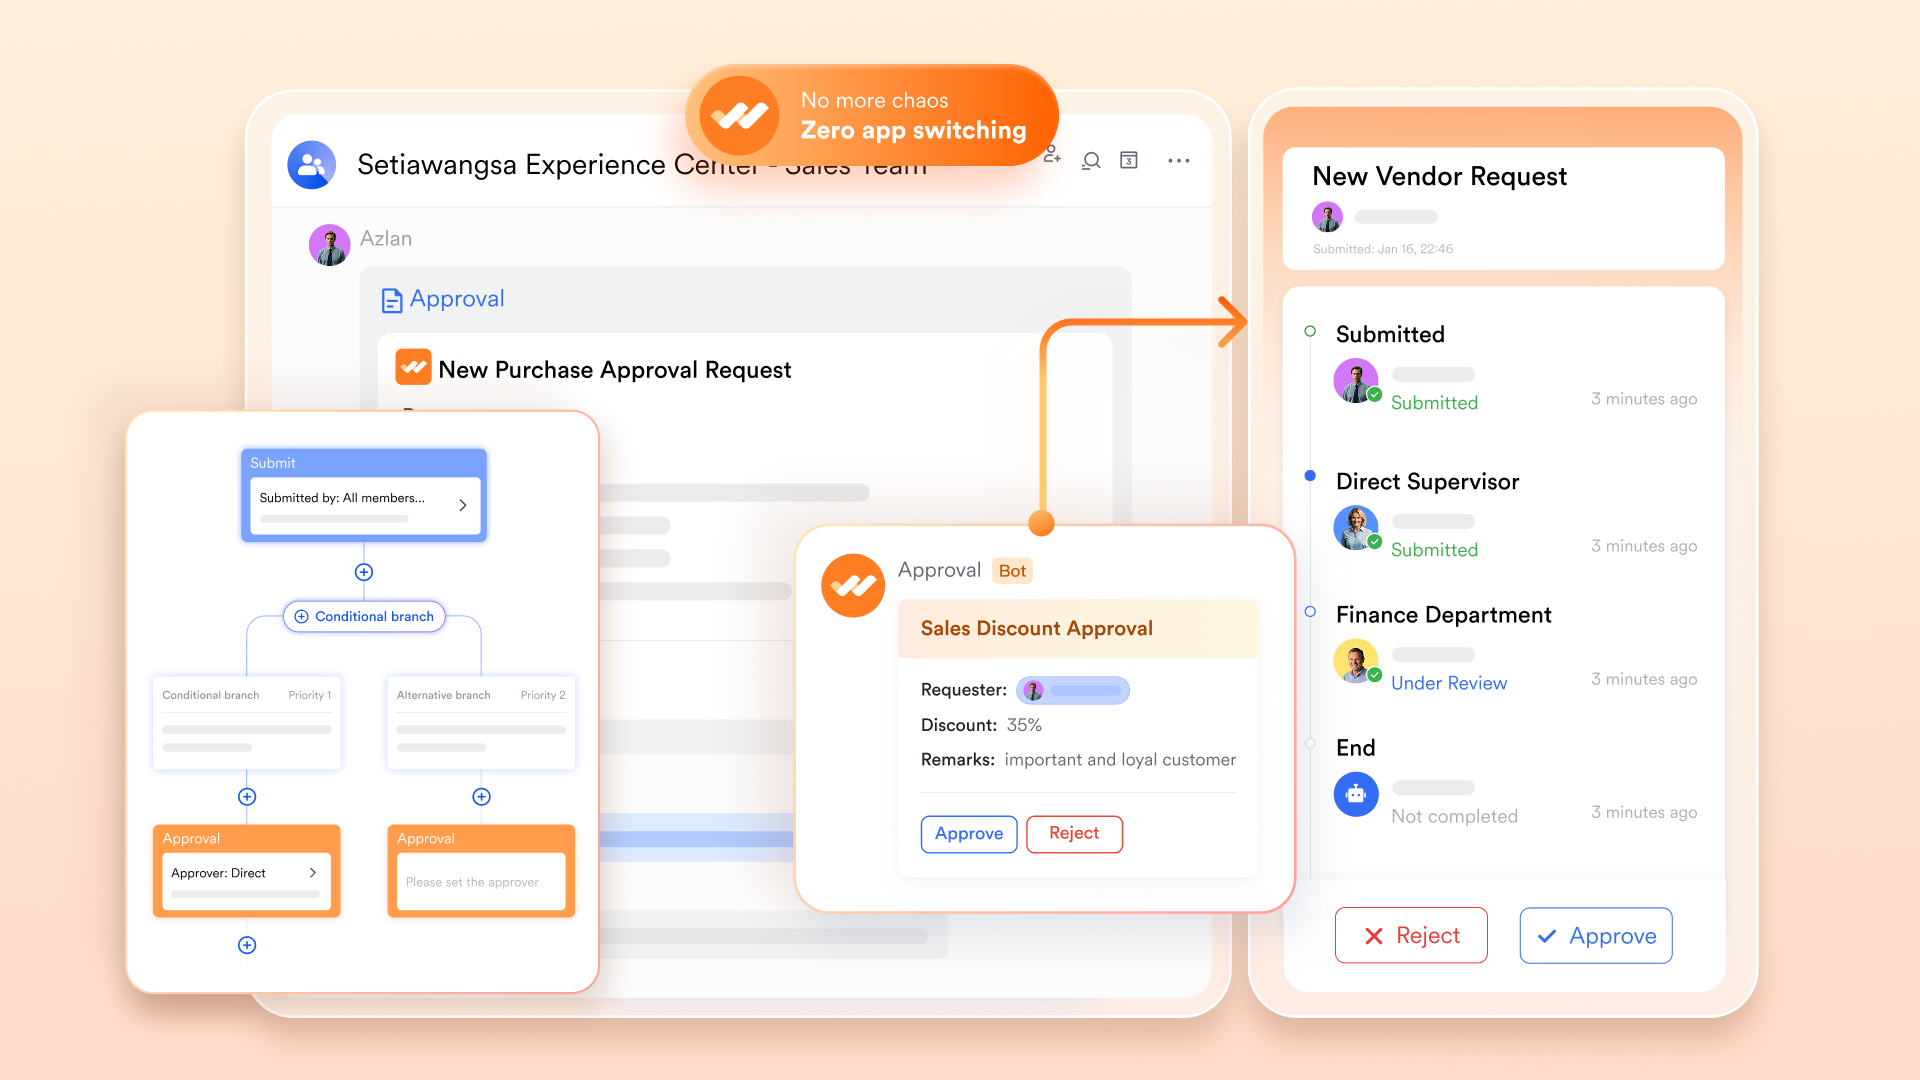
La supervisión de rendimiento moderna va más allá de los equipos de ingeniería. Las organizaciones necesitan cada vez más soluciones que conecten las percepciones de monitoreo con flujos de trabajo, comunicación y procesos de respuesta coordinada. Lark ayuda a los equipos a convertir las señales de rendimiento en acciones operativas reales en todos los departamentos. Al conectar paneles de control, comunicación, automatización y documentación, los equipos pueden responder más rápido y reducir el tiempo de inactividad. Este enfoque fomenta la colaboración interfuncional entre desarrolladores, operaciones y equipos de negocio.
Características clave
Una base de datos de incidentes sin código
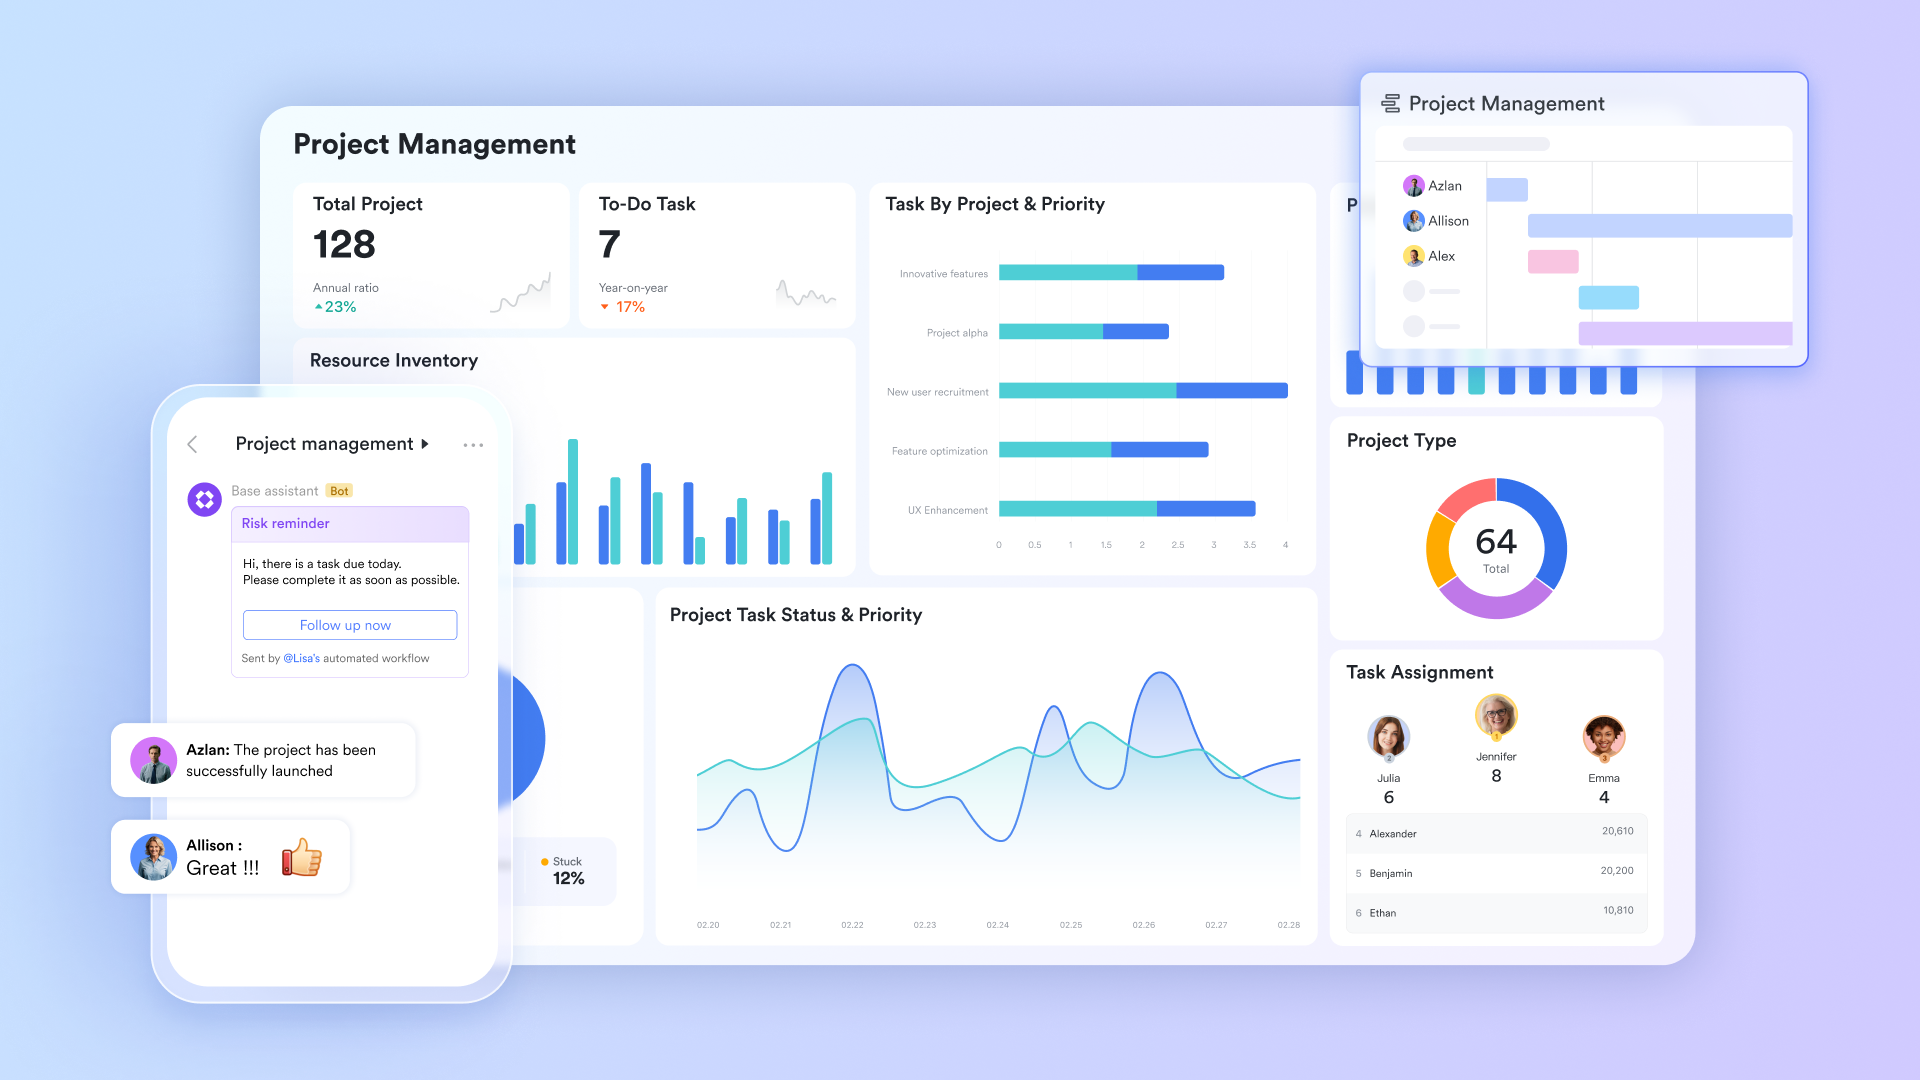
Lark Base permite a los equipos crear paneles estructurados de incidentes y monitoreo sin necesidad de programación. Los equipos pueden crear tablas, paneles y vistas personalizadas para rastrear alertas, interrupciones y el progreso de la remediación en tiempo real. Campos personalizados como gravedad, responsable y el impacto en el servicio brindan claridad inmediata durante los incidentes. La automatización puede activar notificaciones y actualizar estados automáticamente, ayudando a los equipos a mantener visibilidad y actuar rápidamente.
El motor de responsabilidad
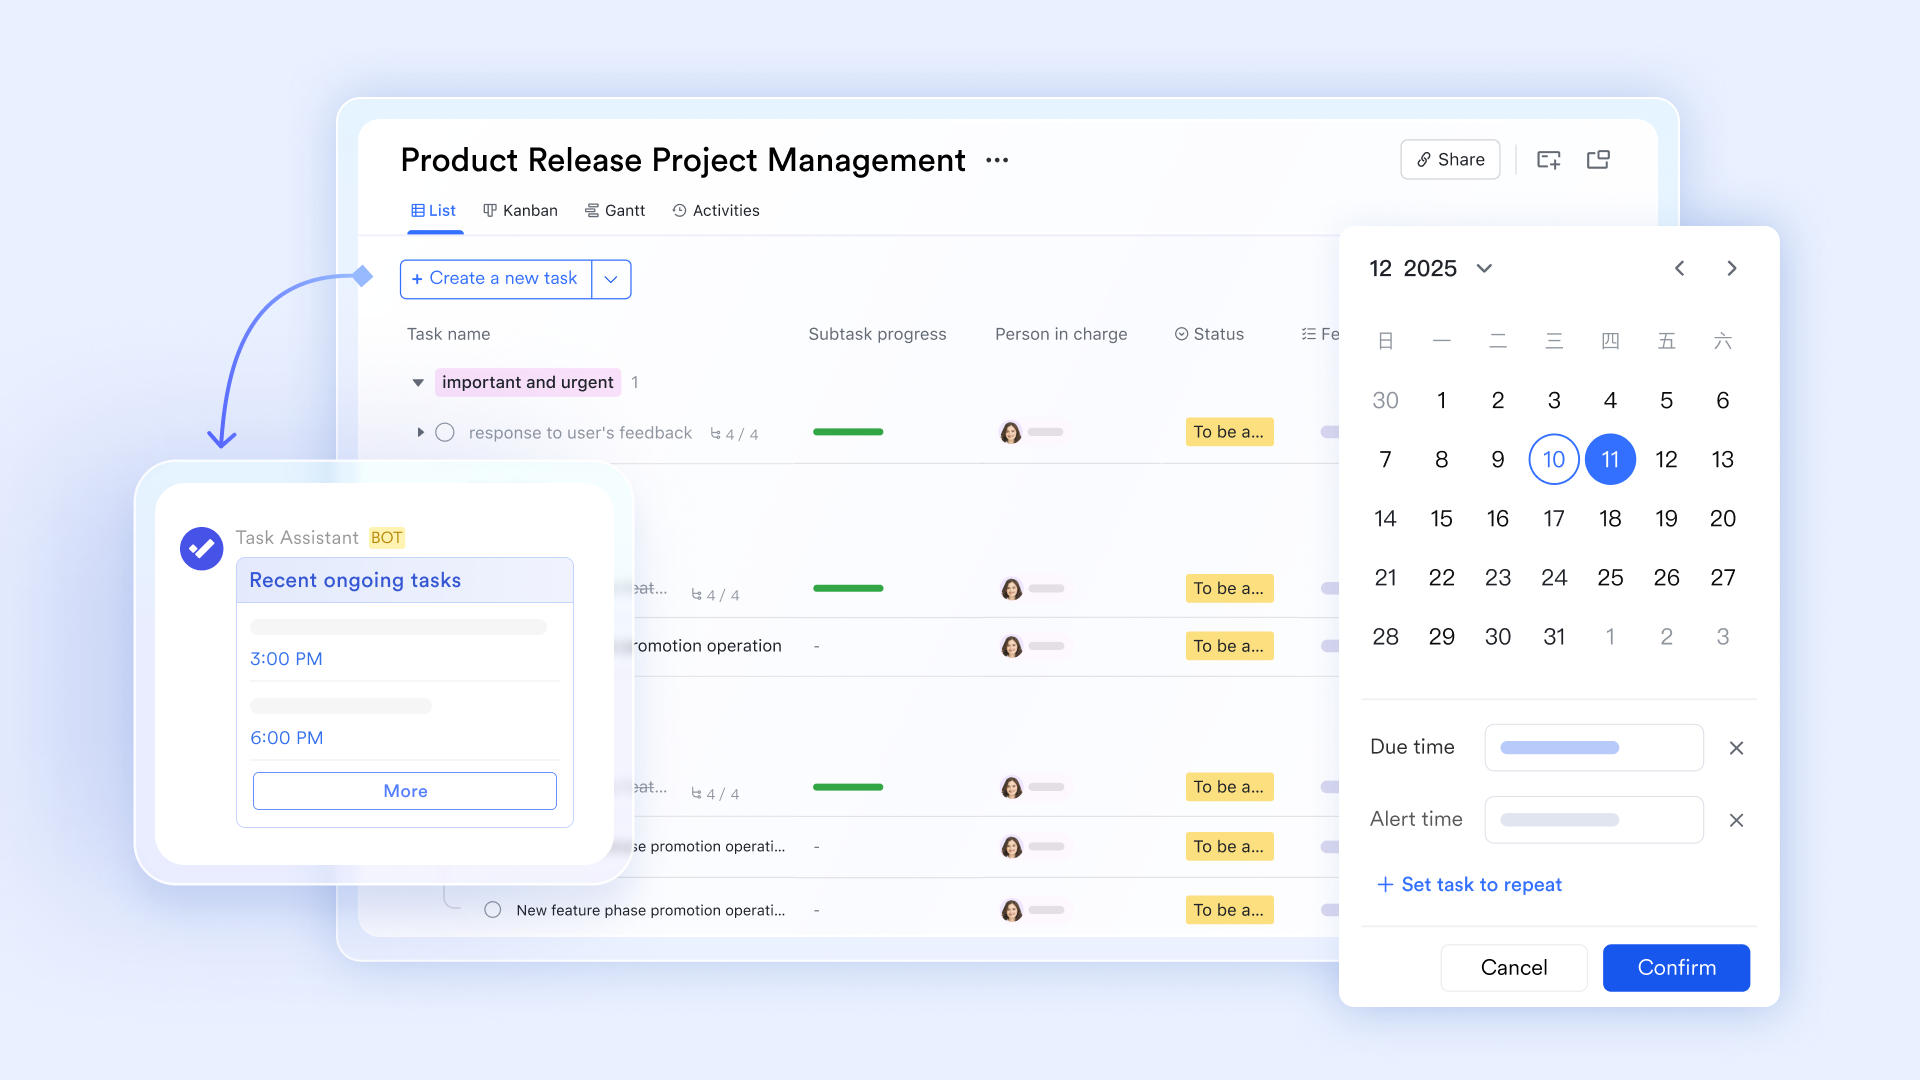
Lark Tasks ofrece un espacio centralizado para rastrear las acciones de respuesta a incidentes y el trabajo de seguimiento. Las tareas pueden asignarse a múltiples colaboradores, dividirse en subtareas y vincularse directamente a los paneles de monitoreo. Los equipos pueden rastrear la responsabilidad y el progreso sin cambiar de herramientas. Esto asegura que las alertas de rendimiento se traduzcan en acciones concretas y responsabilidad entre los equipos.
Coordinación de recursos y respuesta
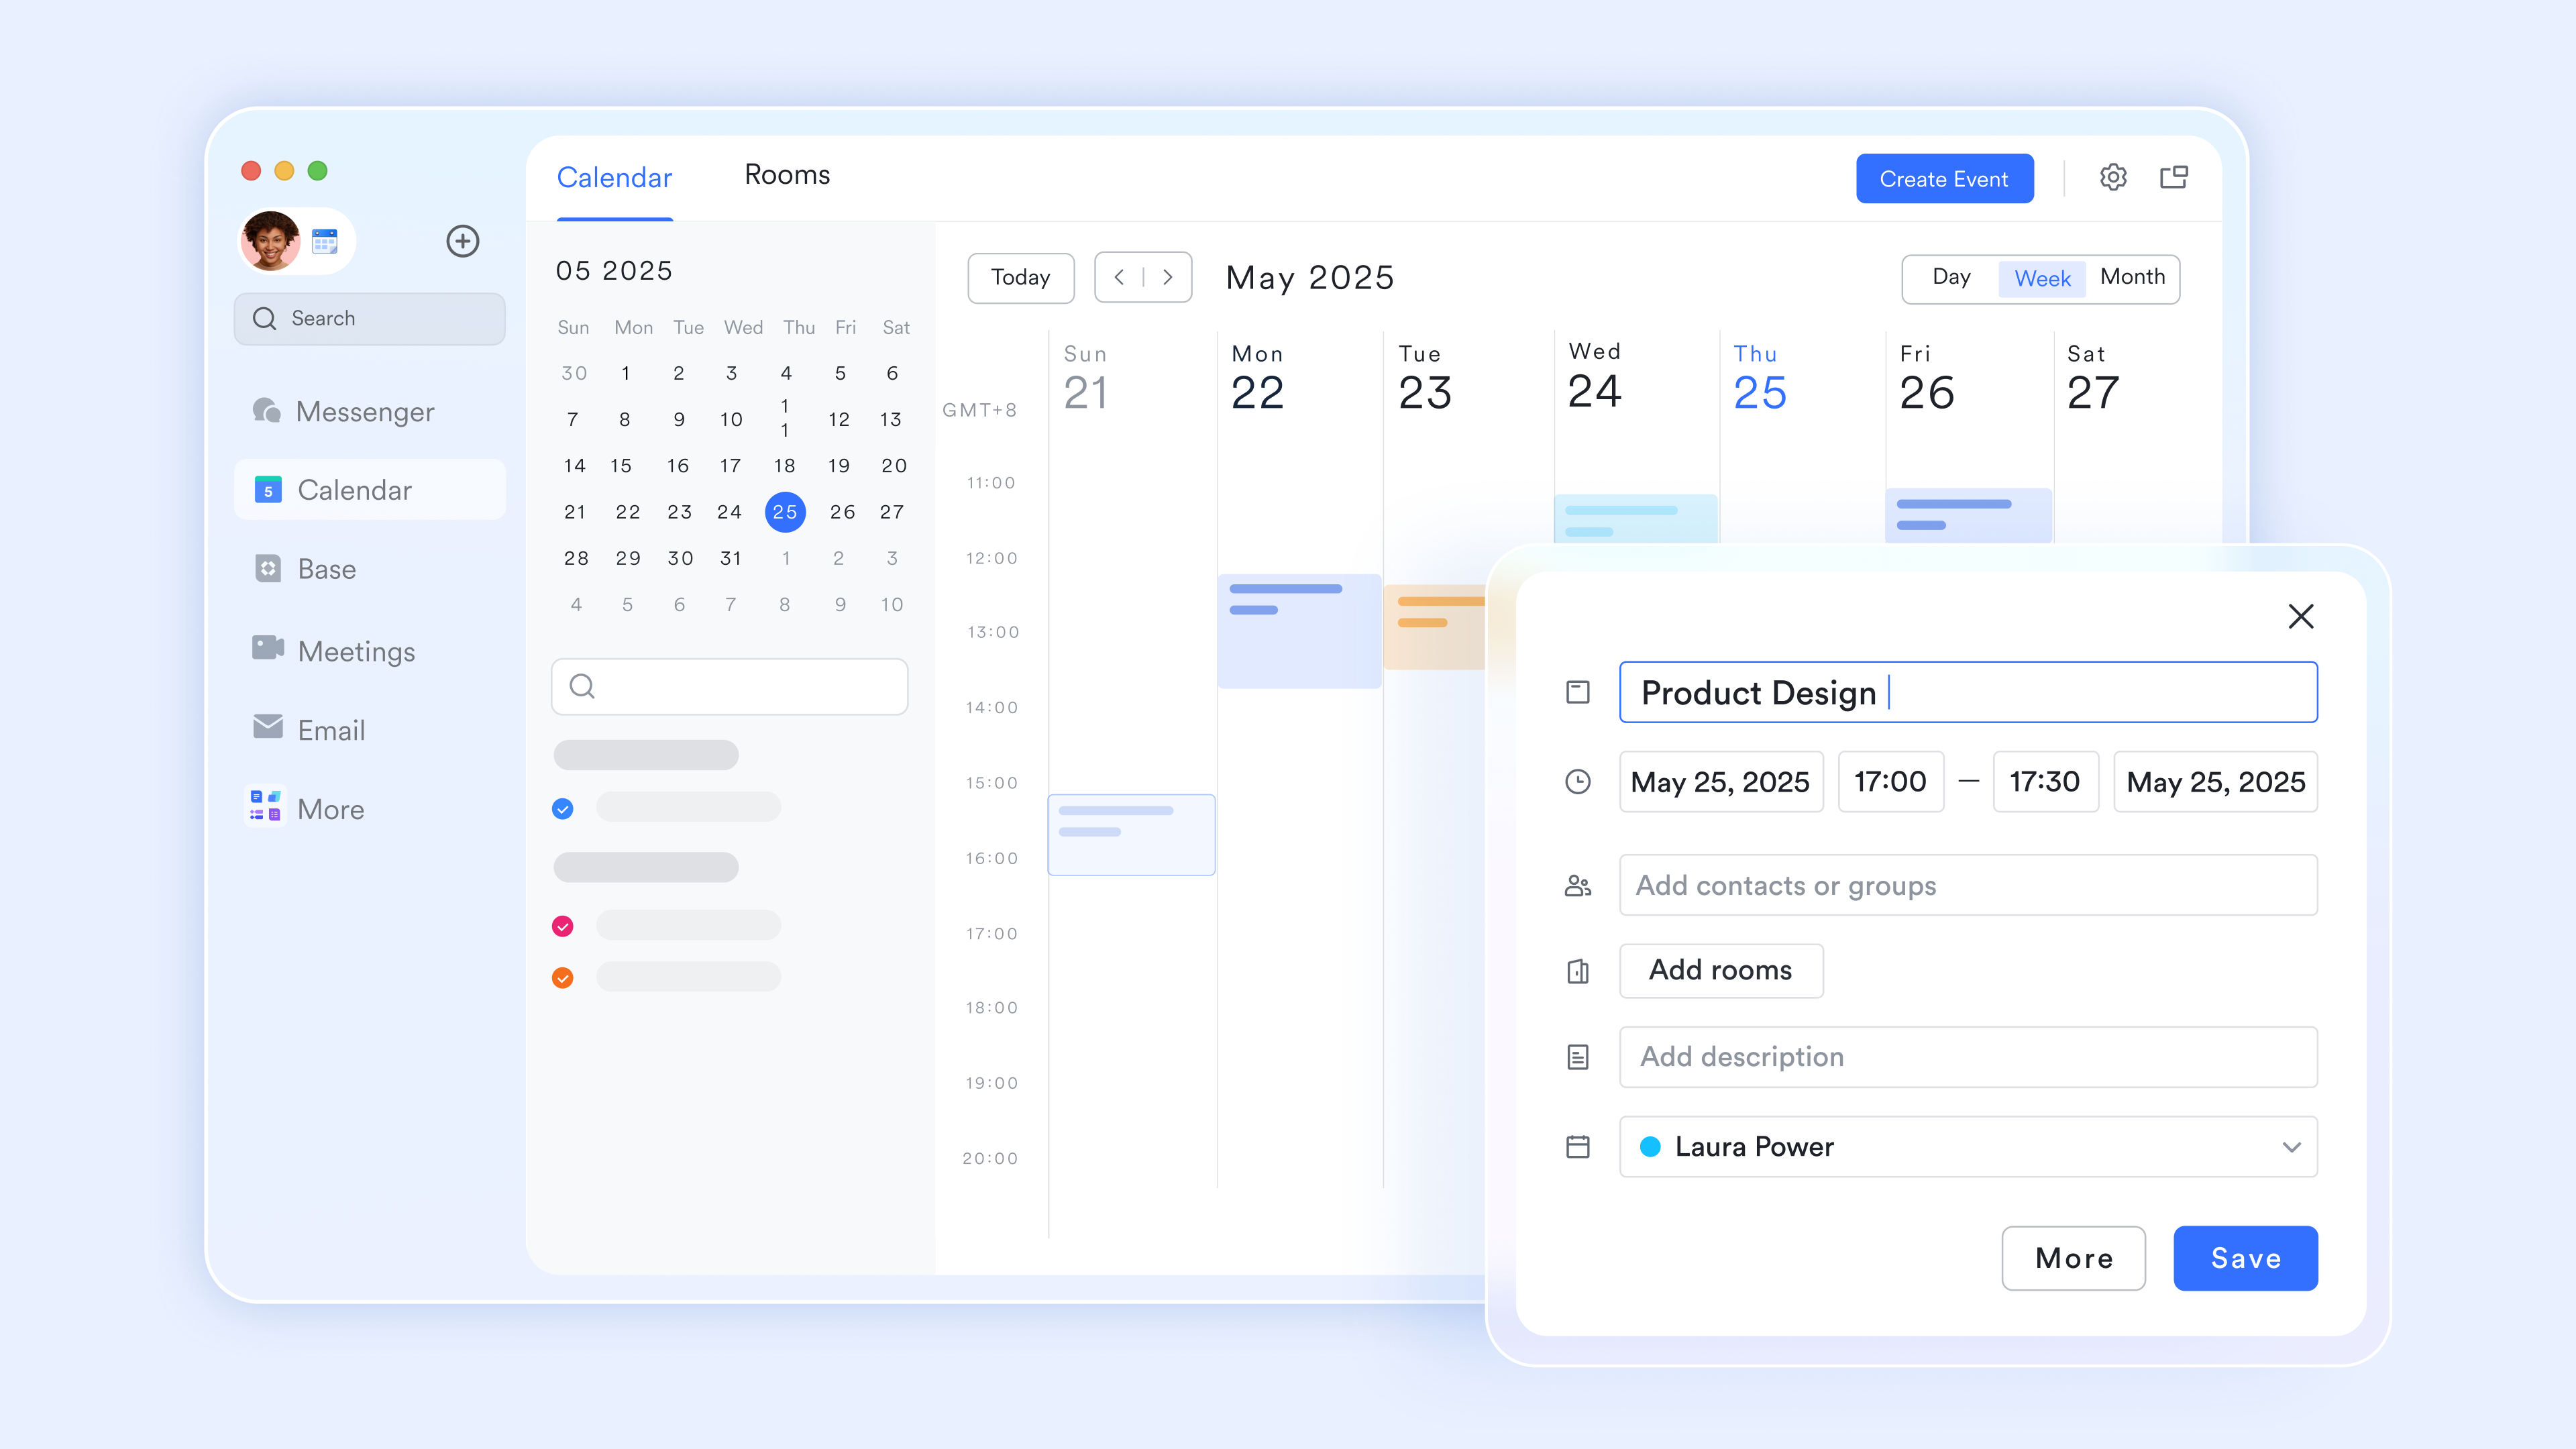
Lark Calendar ayuda a los equipos a coordinar los horarios de respuesta a incidentes, las rotaciones de guardia y las reuniones de revisión. Los calendarios compartidos brindan visibilidad sobre la disponibilidad y la planificación de recursos. Los equipos pueden crear eventos al instante desde chats y paneles para alinear a las partes interesadas. Esto ayuda a garantizar que las personas correctas respondan rápidamente cuando surgen problemas de rendimiento.
Gobernanza de flujo de trabajo estandarizado
Lark Approval ayuda a los equipos a formalizar la remediación y el cambio de flujos de trabajo de gestión. Las organizaciones pueden diseñar procesos de aprobación de varios pasos para implementaciones, correcciones y actualizaciones de infraestructura. El enrutamiento automatizado garantiza que las partes interesadas correctas revisen y aprueben los cambios rápidamente. Esto mejora la gobernanza y reduce los riesgos durante los esfuerzos de recuperación del rendimiento.
Ventajas
- Soporte para colaboración entre equipos: Combina comunicación, documentación y flujos de trabajo en un solo espacio de trabajo. Esto ayuda a que los equipos técnicos y no técnicos se alineen durante incidentes y seguimientos.
- Flujos de trabajo de incidentes impulsados por automatización: Reduce la coordinación manual al automatizar alertas, tareas y aprobaciones. Esto mejora la consistencia y la eficiencia de la respuesta.
- Enfoque de espacio de trabajo unificado: Mantiene las percepciones de rendimiento, las discusiones y las acciones conectadas en una sola plataforma. Esto reduce el cambio entre herramientas y mejora la visibilidad.
- Escalable para equipos distribuidos: Admite la colaboración remota y global con tableros compartidos y reuniones. Esto asegura una coordinación consistente en todas las ubicaciones.
Contras
- Tiempo de incorporación: Las funciones avanzadas requieren tiempo de incorporación, pero el Centro de ayuda ofrece guías claras.
- Plan inicial: Plan gratuito para siempre que incluye 11 herramientas potentes para hasta 20 usuarios. También incluye 100 GB de almacenamiento, 1000 ejecuciones de automatización, traducciones con IA y más.
- Plan básico: $6/usuario/mes (facturado anualmente) para hasta 500 usuarios. Incluye todo lo del plan inicial más llamadas grupales para hasta 500 asistentes, 5 TB de almacenamiento, 1000 ejecuciones de automatización y más. Para más detalles, por favor contacte al equipo de ventas.
- Plan Pro: $12/usuario/mes (facturado anualmente) para un máximo de 500 usuarios. Incluye todo lo del plan Básico más llamadas grupales para hasta 500 asistentes, 15 TB de almacenamiento, 50,000 ejecuciones de automatización y más.
- Plan Empresarial: Contactar ventas para precios personalizados. Admite usuarios ilimitados e incluye aún más ejecuciones de automatización y funciones avanzadas de seguridad, cumplimiento y gestión.

Starter
Pro
Enterprise
Starter
For small teams with simple communication needs
$0
/ user / month
20 users max
18 months message history
1-on-1 video meetings
100 GB storage
Lark Docs & Mail
1000 Base automation runs/month
2000 rows per table in Base
Pro
For companies with comprehensive collaboration and management needs
$12
/ user / month
500 users max
Unlimited message history
500-participant video meetings
15 TB storage
Lark Docs & Mail
50k Base automation runs/month
20k rows per table in Base
Enterprise
For large companies with advanced security and organizational management needs
Get a personalized demo and pricing
Unlimited users
Unlimited message history
500-participant video meetings
15 TB storage + 30 GB storage/user
Lark Docs & Mail
500k Base automation runs/month
50k Base automation runs/month
Single sign-on (SSO)
Pro
For companies with comprehensive collaboration and management needs
$12
/ user / month
500 users max
Unlimited message history
500-participant video meetings
15 TB storage
Lark Docs & Mail
50k Base automation runs/month
20k rows per table in Base
2. Datadog: Potencia de monitoreo y análisis nativa en la nube
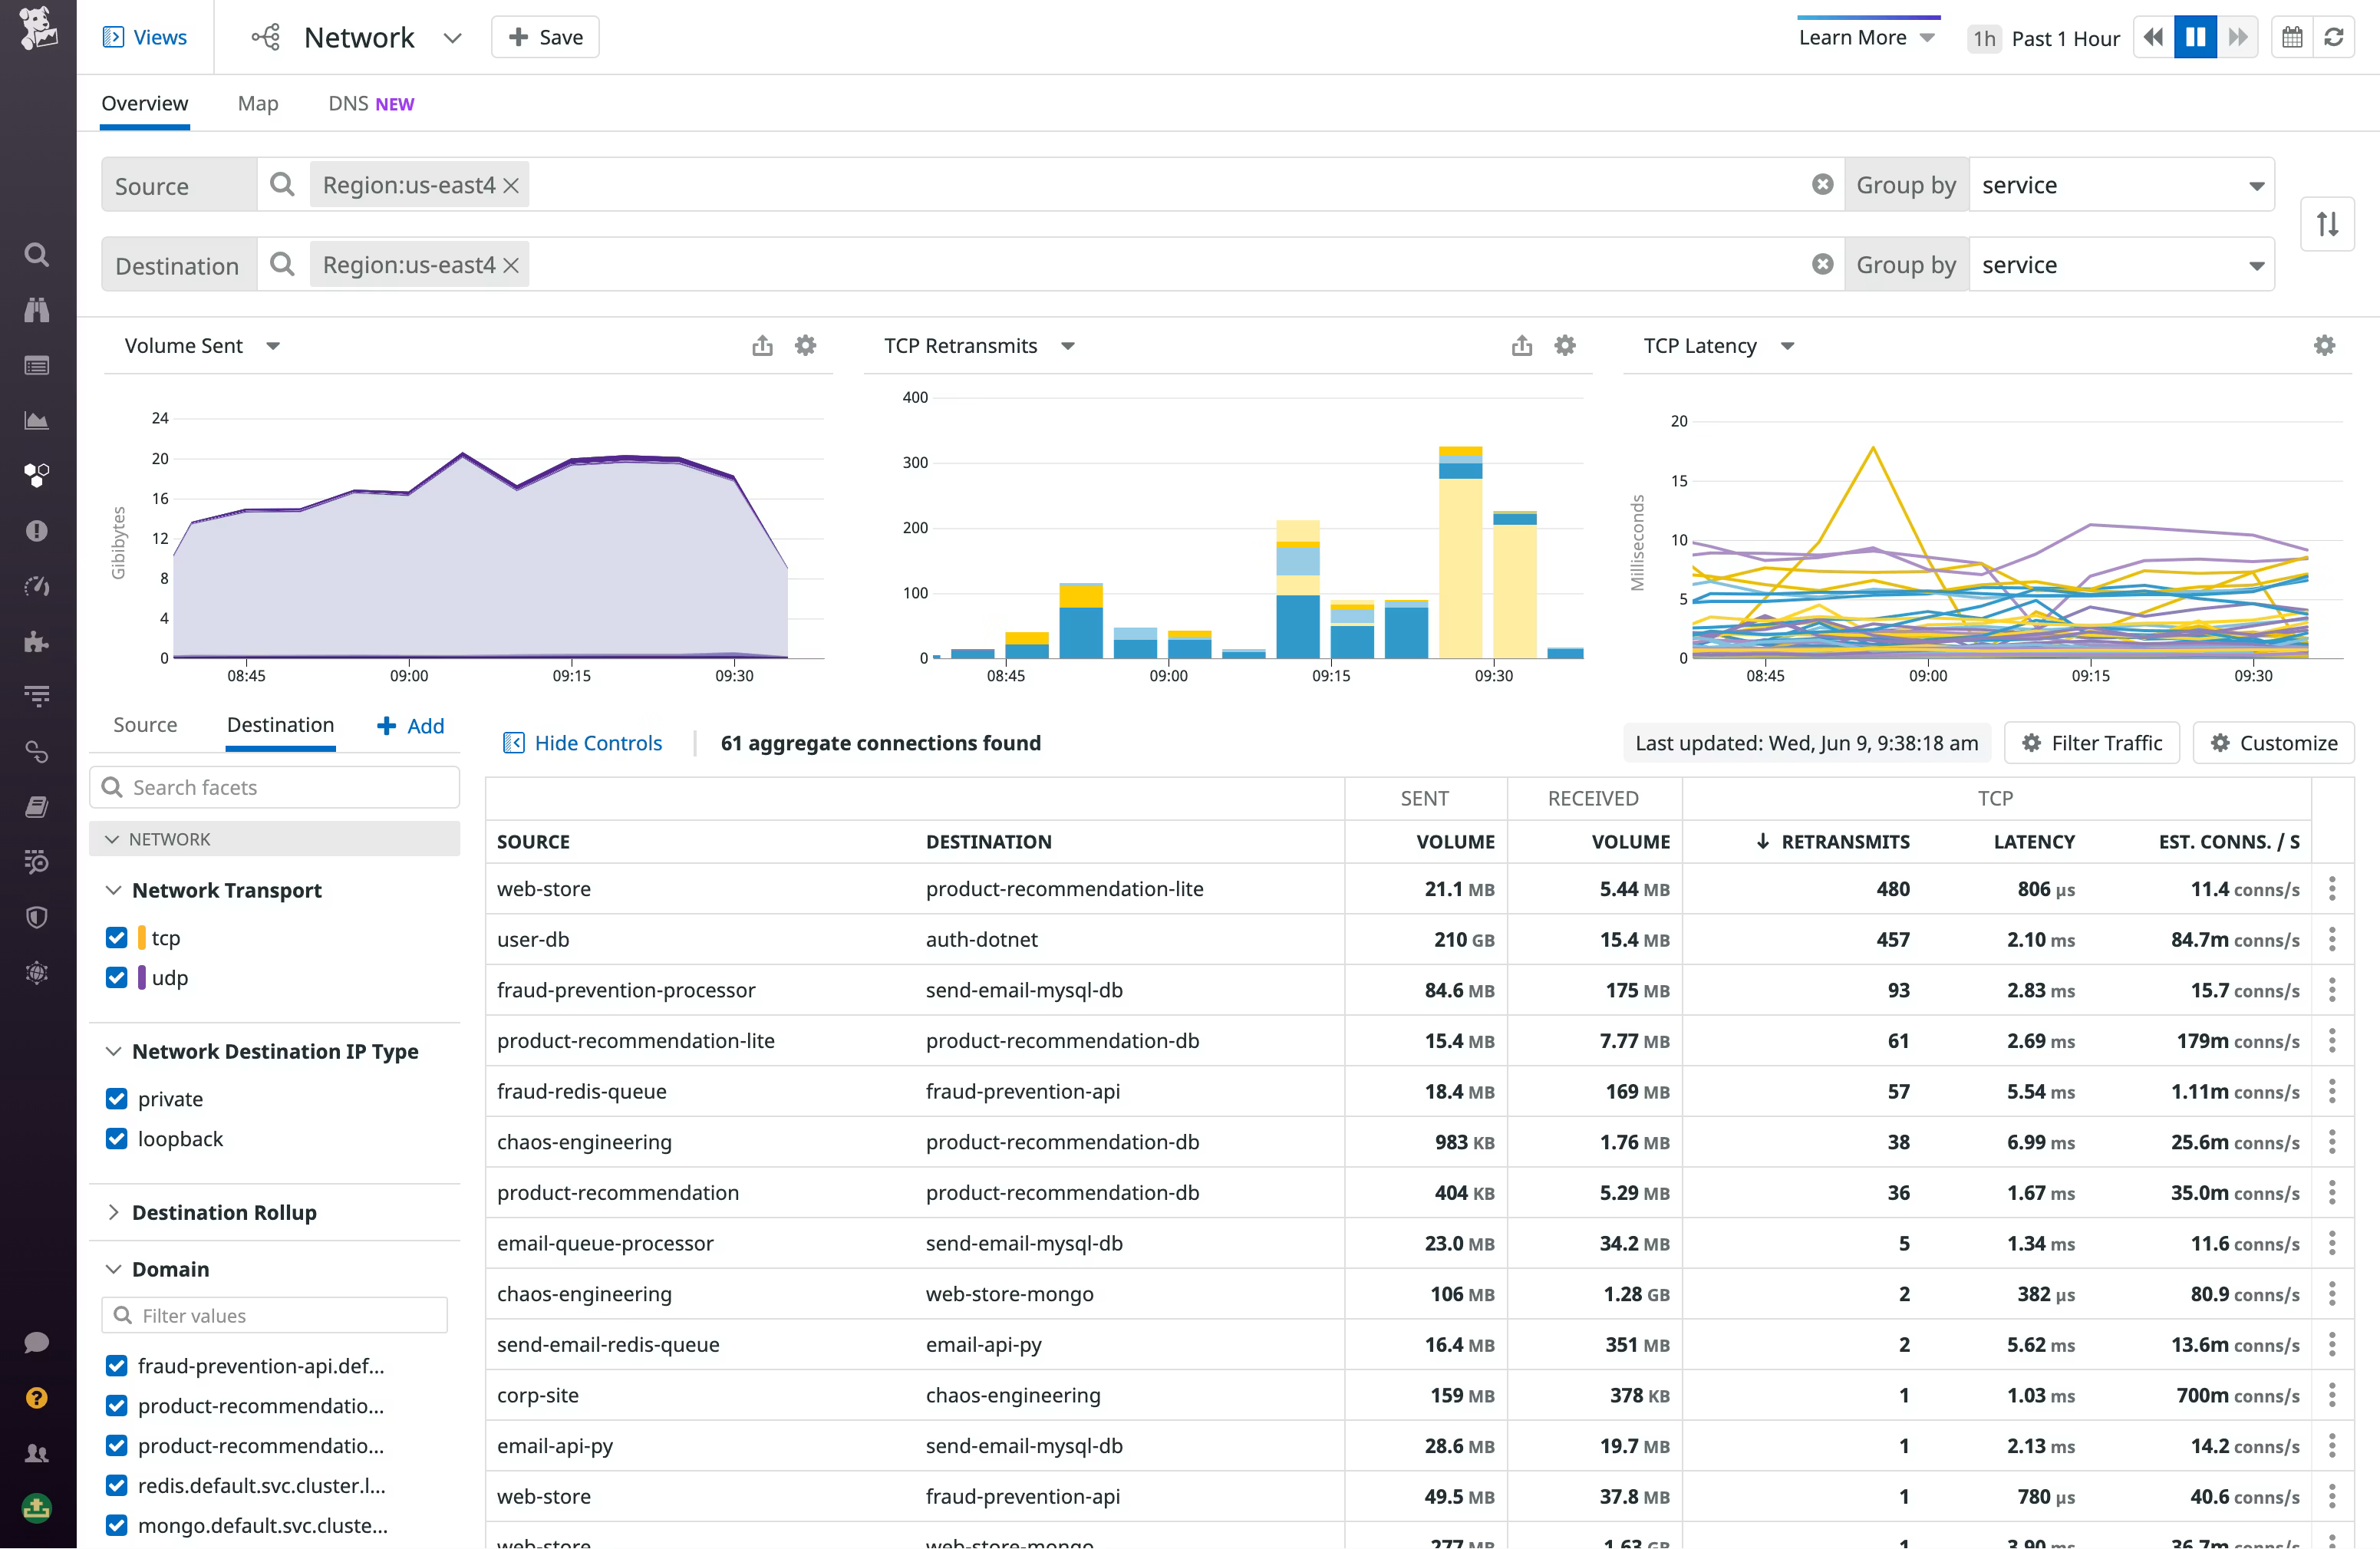
Datadog es una de las herramientas de gestión del rendimiento de aplicaciones nativas en la nube más ampliamente adoptadas. Proporciona visibilidad unificada a través de la infraestructura, las aplicaciones, los registros y las trazas. La plataforma es particularmente sólida en entornos con contenedores y microservicios. Las organizaciones confían en Datadog para el monitoreo en tiempo real de sistemas distribuidos. Su extenso ecosistema de integraciones la hace altamente flexible para las pilas modernas de nube.
Fuente de la imagen: datadoghq.com
Características clave
- Paneles de observabilidad unificada: Combina métricas, registros y trazas en paneles centralizados. Esto mejora la visibilidad a través de las capas de infraestructura y aplicación.
- Detección de anomalías mediante aprendizaje automático: Identifica automáticamente patrones inusuales y reduce la fatiga por alertas. Los conocimientos impulsados por IA mejoran la precisión de la detección.
- Amplia biblioteca de integraciones: Compatible con cientos de integraciones en proveedores de nube y herramientas SaaS. Esto garantiza una compatibilidad fluida dentro del ecosistema.
- Monitoreo de usuarios reales: Rastrea las interacciones de los usuarios finales para mejorar la optimización de la experiencia digital.
Ventajas
- Sólido soporte nativo en la nube: Ideal para Kubernetes, contenedores y entornos multinube.
- Motor de análisis escalable: Maneja datos de telemetría a gran escala de manera eficiente.
- Amplias capacidades de visualización: Los paneles admiten análisis detallado del rendimiento.
Contras
- Crecimiento de costos basado en el uso: Los costos de monitoreo pueden aumentar rápidamente con mayores volúmenes de ingesta.
- Configuración compleja a gran escala: Las implementaciones grandes pueden requerir ajustes y experiencia.
Precios
- Plantilla estándar de APM: $31/host/mes (facturado anualmente).
- Plantilla Pro de APM: $35/host/mes (facturado anualmente).
- Plantilla Enterprise de APM: $40/host/mes (facturado anualmente).
- Plantilla Flex de APM: $3.50/millón de spans (ingestados) más $1.70/millón de spans (indexados).
3. New Relic: Observabilidad de pila completa para aplicaciones modernas
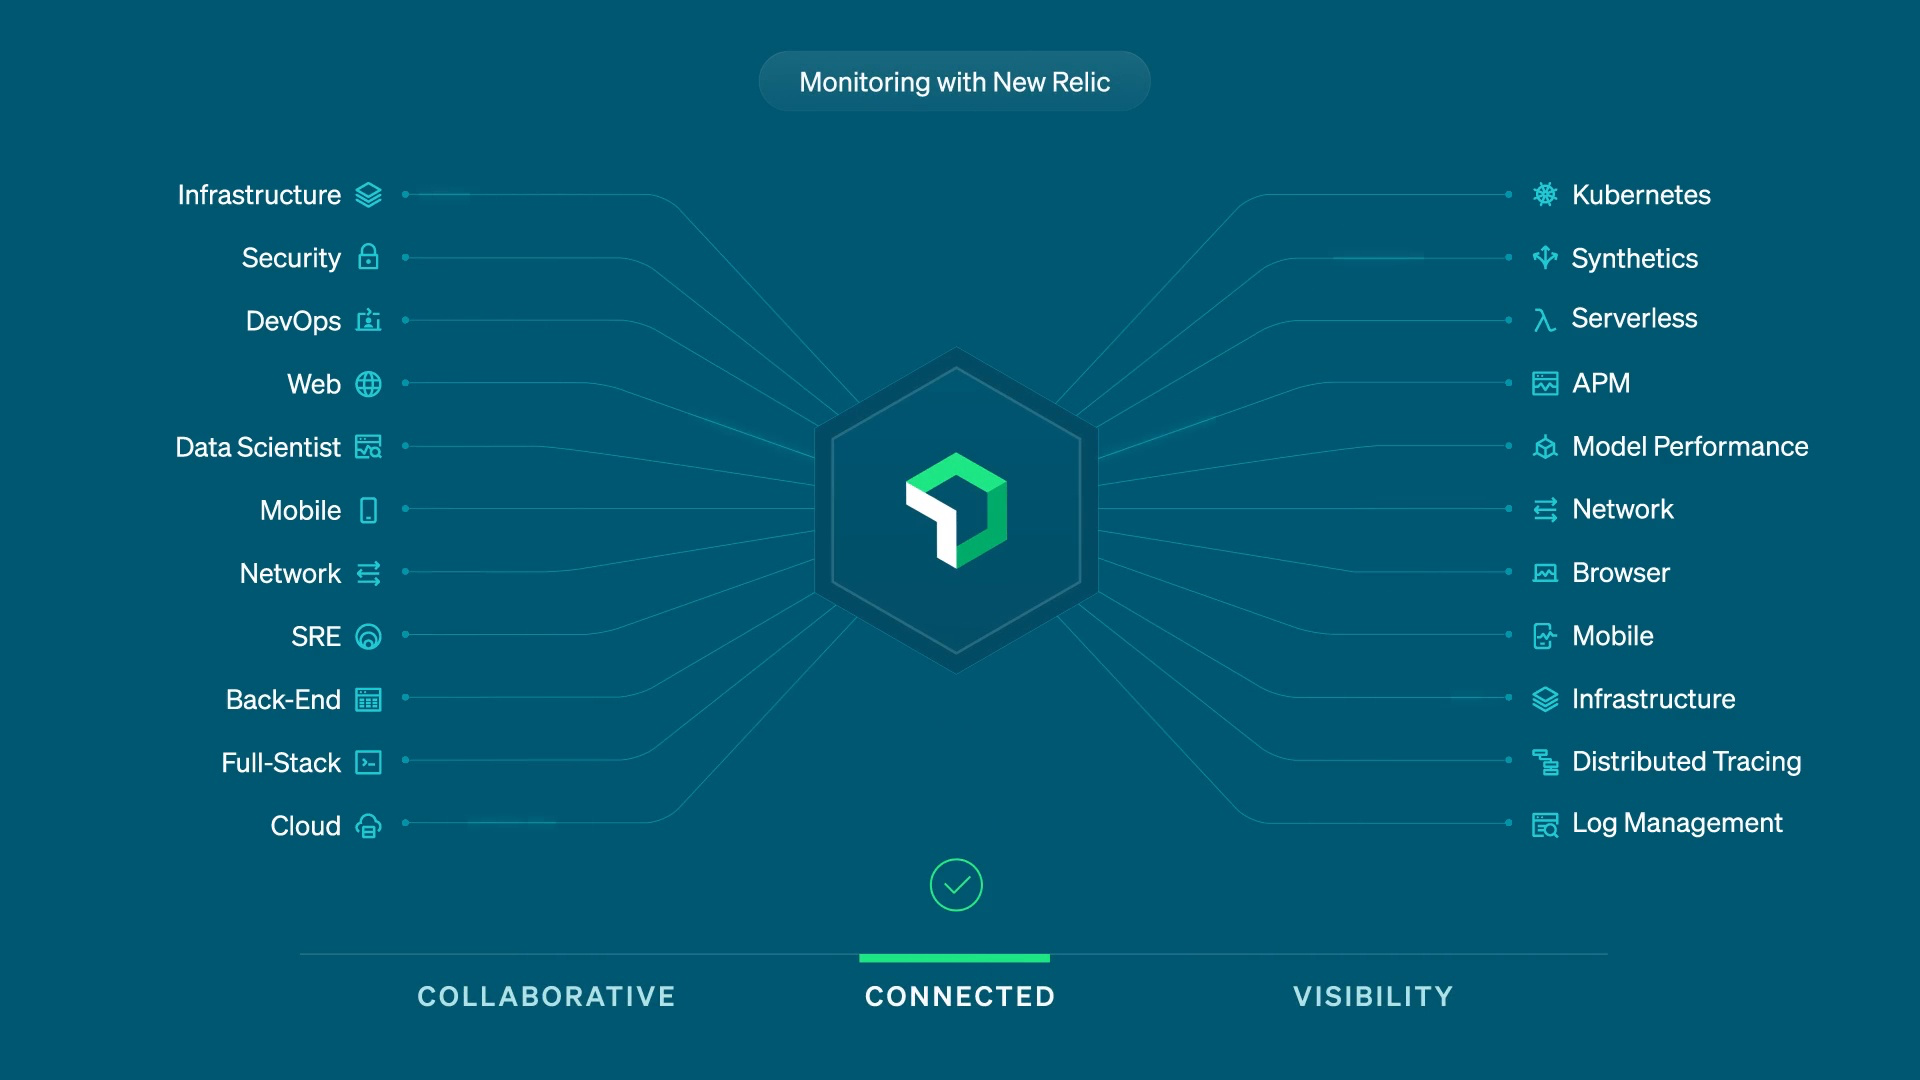
New Relic ofrece una observabilidad integral de pila completa para infraestructura, aplicaciones y experiencia del usuario. Es ampliamente adoptado por equipos de DevOps y SRE que gestionan entornos distribuidos. La plataforma se enfoca en visibilidad en tiempo real y una ingesta de datos flexible. Su modelo basado en uso ofrece escalabilidad para equipos en crecimiento. New Relic admite implementaciones nativas en la nube, híbridas y en contenedores.
Fuente de la imagen: newrelic.com
Características clave
- Plataforma de monitoreo de pila completa: Proporciona visibilidad en servidores, contenedores, servicios y aplicaciones. La telemetría unificada mejora la velocidad de resolución de problemas.
- Herramientas de monitoreo de usuarios reales: Rastrea métricas de rendimiento de usuarios en el mundo real para respaldar la optimización de la experiencia del cliente.
- Información impulsada por IA: Proporciona alertas predictivas y análisis de causa raíz para reducir el tiempo de resolución de incidentes.
- Tableros personalizables: Los equipos crean tableros adaptados a los KPI de ingeniería y negocios.
Ventajas
- Ecosistema amigable para desarrolladores: Se integra bien con flujos de trabajo CI/CD y DevOps.
- Modelo flexible de ingesta de datos: Se escala según los requisitos de uso.
- Potente rastreo distribuido: Ayuda a identificar cuellos de botella en los microservicios.
Contras
- Sensibilidad al costo por volumen de datos: Un mayor volumen de ingesta incrementa los costos.
- Curva de aprendizaje para la optimización: Los flujos de trabajo avanzados requieren experiencia en configuración.
Precios
- Precios para empresas: Precios personalizados disponibles mediante consulta con el proveedor.
4. Dynatrace: plataforma empresarial de APM impulsada por IA
Dynatrace está diseñado para empresas que gestionan entornos complejos y de gran escala. Su motor Davis AI ofrece detección automática de la causa raíz y análisis predictivo. La plataforma admite entornos híbridos y multinube. Dynatrace mapea automáticamente las dependencias de las aplicaciones, reduciendo la configuración manual. A menudo es elegido por grandes empresas que priorizan la automatización y la escalabilidad.
Fuente de la imagen: dynatrace.com
Características clave
- Motor Davis AI: Proporciona detección automática de anomalías y análisis de causa raíz. Reduce significativamente el tiempo de resolución de problemas.
- Descubrimiento automático de servicios: Mapea las dependencias en toda la infraestructura y los servicios. Mejora la visibilidad de toda la pila.
- Motor de análisis en tiempo real: Procesa datos de telemetría para obtener información inmediata sobre el rendimiento.
- Soporte de nube empresarial: Admite arquitecturas híbridas y multinube.
Ventajas
- Automatización avanzada de IA: Reduce la carga de supervisión manual.
- Escalabilidad de nivel empresarial: Maneja implementaciones complejas y de alto volumen.
- Alta precisión en la causa raíz: Mejora la eficiencia en la resolución.
Contras
- Precios premium para empresas: Puede no ajustarse al presupuesto de equipos pequeños.
- Proceso de incorporación complejo: Requiere una implementación estructurada.
Precios
- Plantilla de monitoreo de infraestructura: Precio de $0.04/hora/host.
- Plantilla de monitoreo de pila completa: Precio de $0.08/hora/host de 8 GiB.
- Plantilla de monitoreo de plataforma Kubernetes: Precio de $0.002/hora/pod (aproximadamente $1.40/mes).
5. AppDynamics: solución de APM enfocada en el rendimiento empresarial
AppDynamics se enfoca en vincular el rendimiento técnico con los resultados empresariales. Proporciona un rastreo profundo de transacciones y análisis. La plataforma se utiliza comúnmente en entornos empresariales donde el rendimiento impacta directamente en los ingresos y la experiencia del cliente. AppDynamics enfatiza la visibilidad de las transacciones comerciales y los KPI. Admite implementaciones tanto en SaaS como en instalaciones locales.
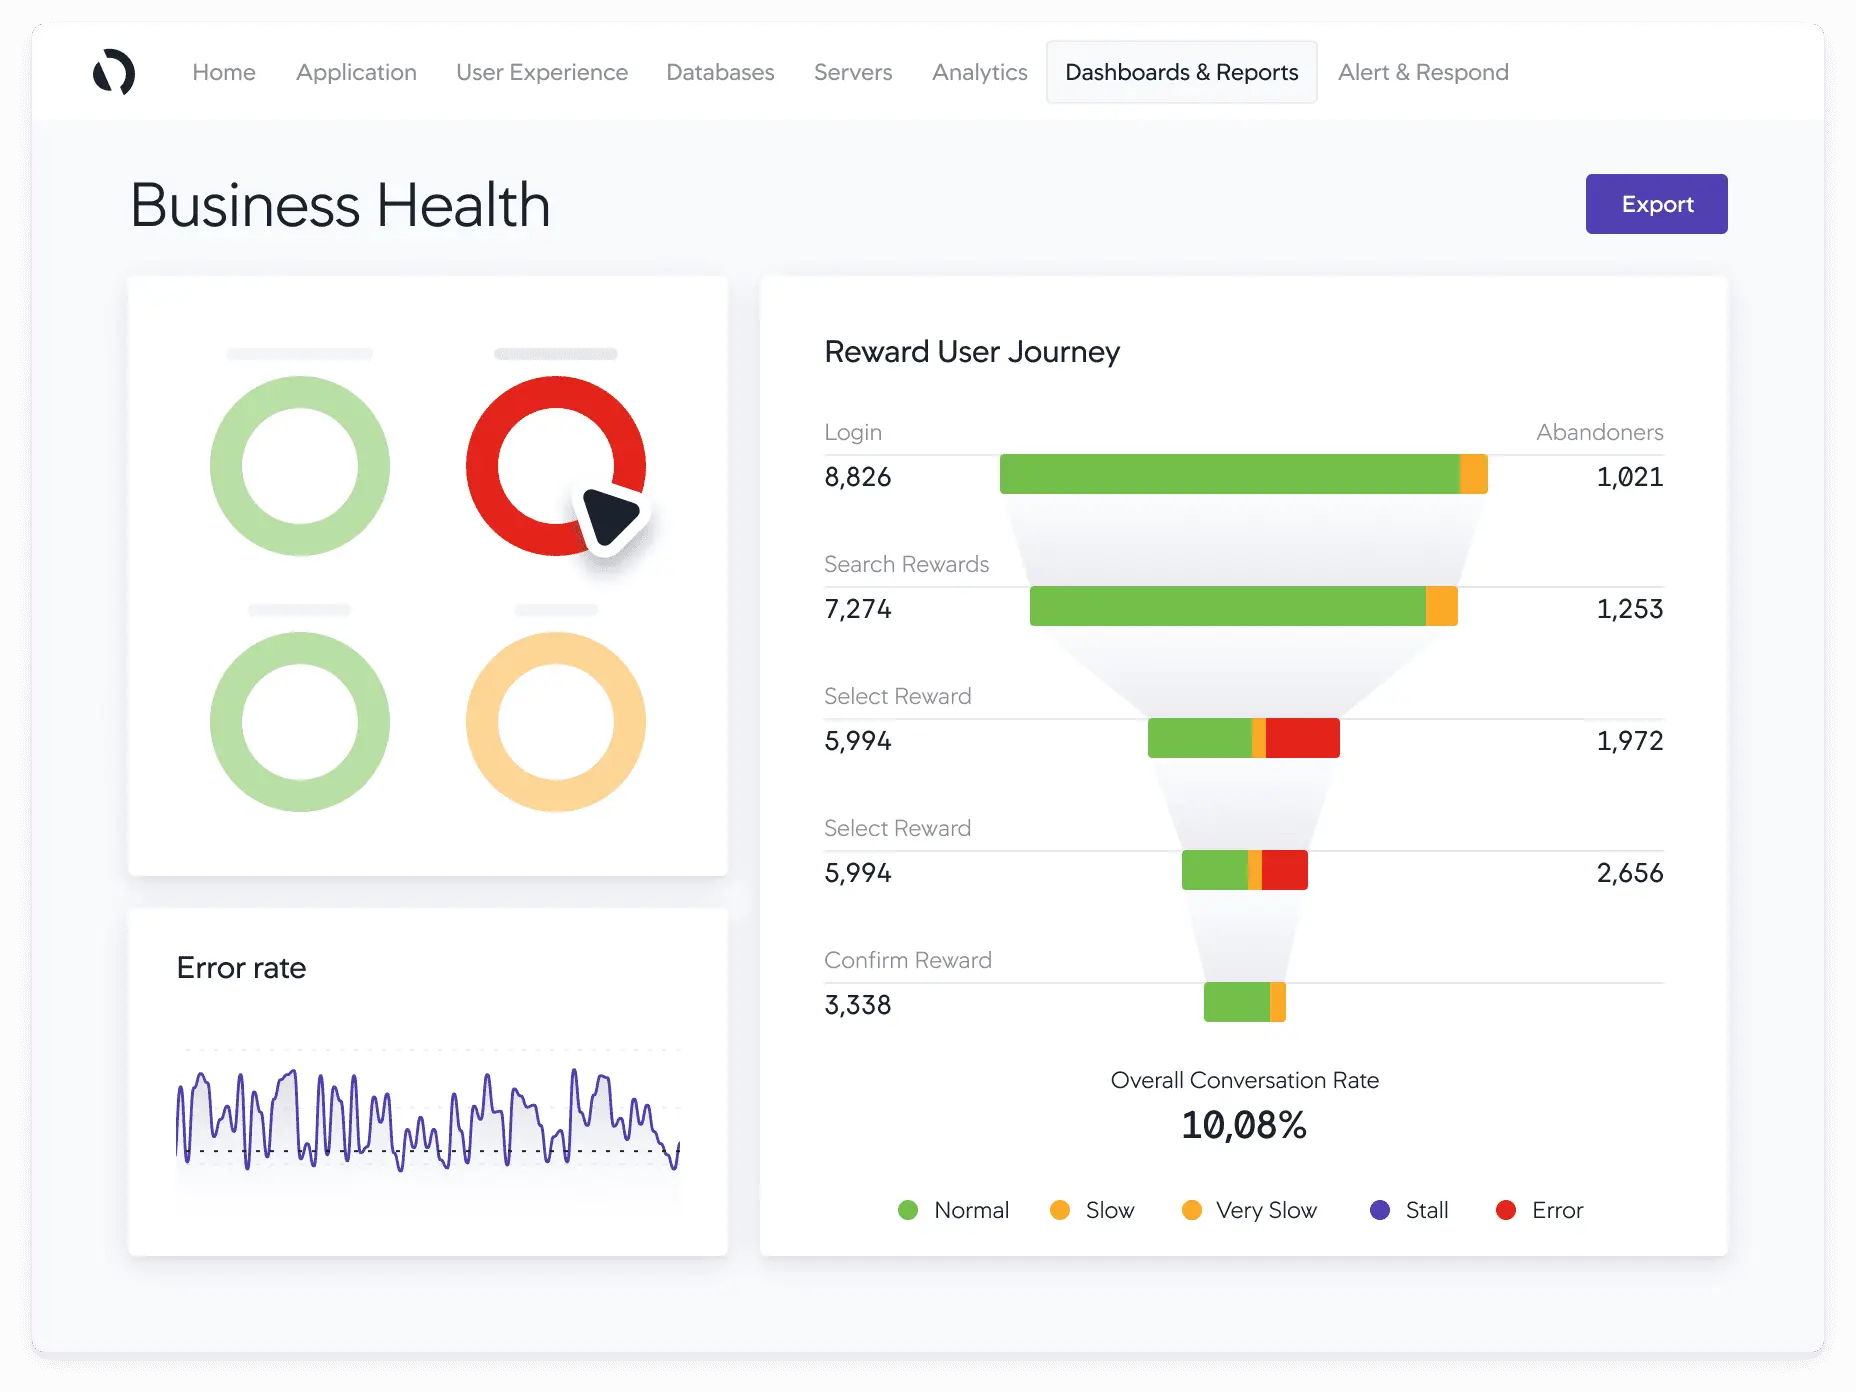
Fuente de la imagen: appdynamics.co
Características clave
- Monitoreo de transacciones comerciales: Conecta métricas de rendimiento con ingresos y recorridos de usuario. Mejora el análisis del impacto empresarial.
- Rastreo de extremo a extremo: Rastrea transacciones distribuidas en entornos complejos. Mejora la precisión en la resolución de problemas.
- Motor de correlación con IA: Correlaciona automáticamente anomalías en la infraestructura y las aplicaciones.
- Compatibilidad con implementación híbrida: Admite entornos SaaS y locales.
Ventajas
- Integración sólida de visibilidad empresarial: Vincula datos técnicos con KPIs estratégicos.
- Escalabilidad empresarial: Diseñado para organizaciones grandes.
- Capacidades de rastreo detalladas: Ayuda a aislar cuellos de botella rápidamente.
Contras
- Costo de implementación más alto: El enfoque empresarial puede limitar la accesibilidad.
- Complejidad de configuración: Requiere planificación estructurada de la implementación.
Precios
- Plantilla de la Edición de Monitoreo de Infraestructura: $6/vCPU/mes.
- Plantilla de la Edición Premium: $33/vCPU/mes.
- Plantilla de la Edición Empresarial: $50/vCPU/mes.
- Plantilla de Monitoreo de Usuario Real (RUM): a partir de aproximadamente $0.06/1,000 tokens y seguimientos.
- Plantilla de Analítica de Registros: a partir de aproximadamente $1,350/año/5GB/día.
6. SolarWinds: software de monitoreo de rendimiento con prioridad en la infraestructura
SolarWinds es ampliamente conocido por el monitoreo de infraestructura y redes, con sólidas capacidades en el seguimiento del rendimiento de aplicaciones. Es particularmente popular entre los equipos de operaciones de TI que gestionan entornos locales y híbridos. La plataforma ofrece una visibilidad profunda de servidores, bases de datos y componentes de red. Las organizaciones que priorizan la estabilidad de la infraestructura suelen elegir SolarWinds. Es adecuado para entornos de TI de tamaño mediano hasta empresarial.
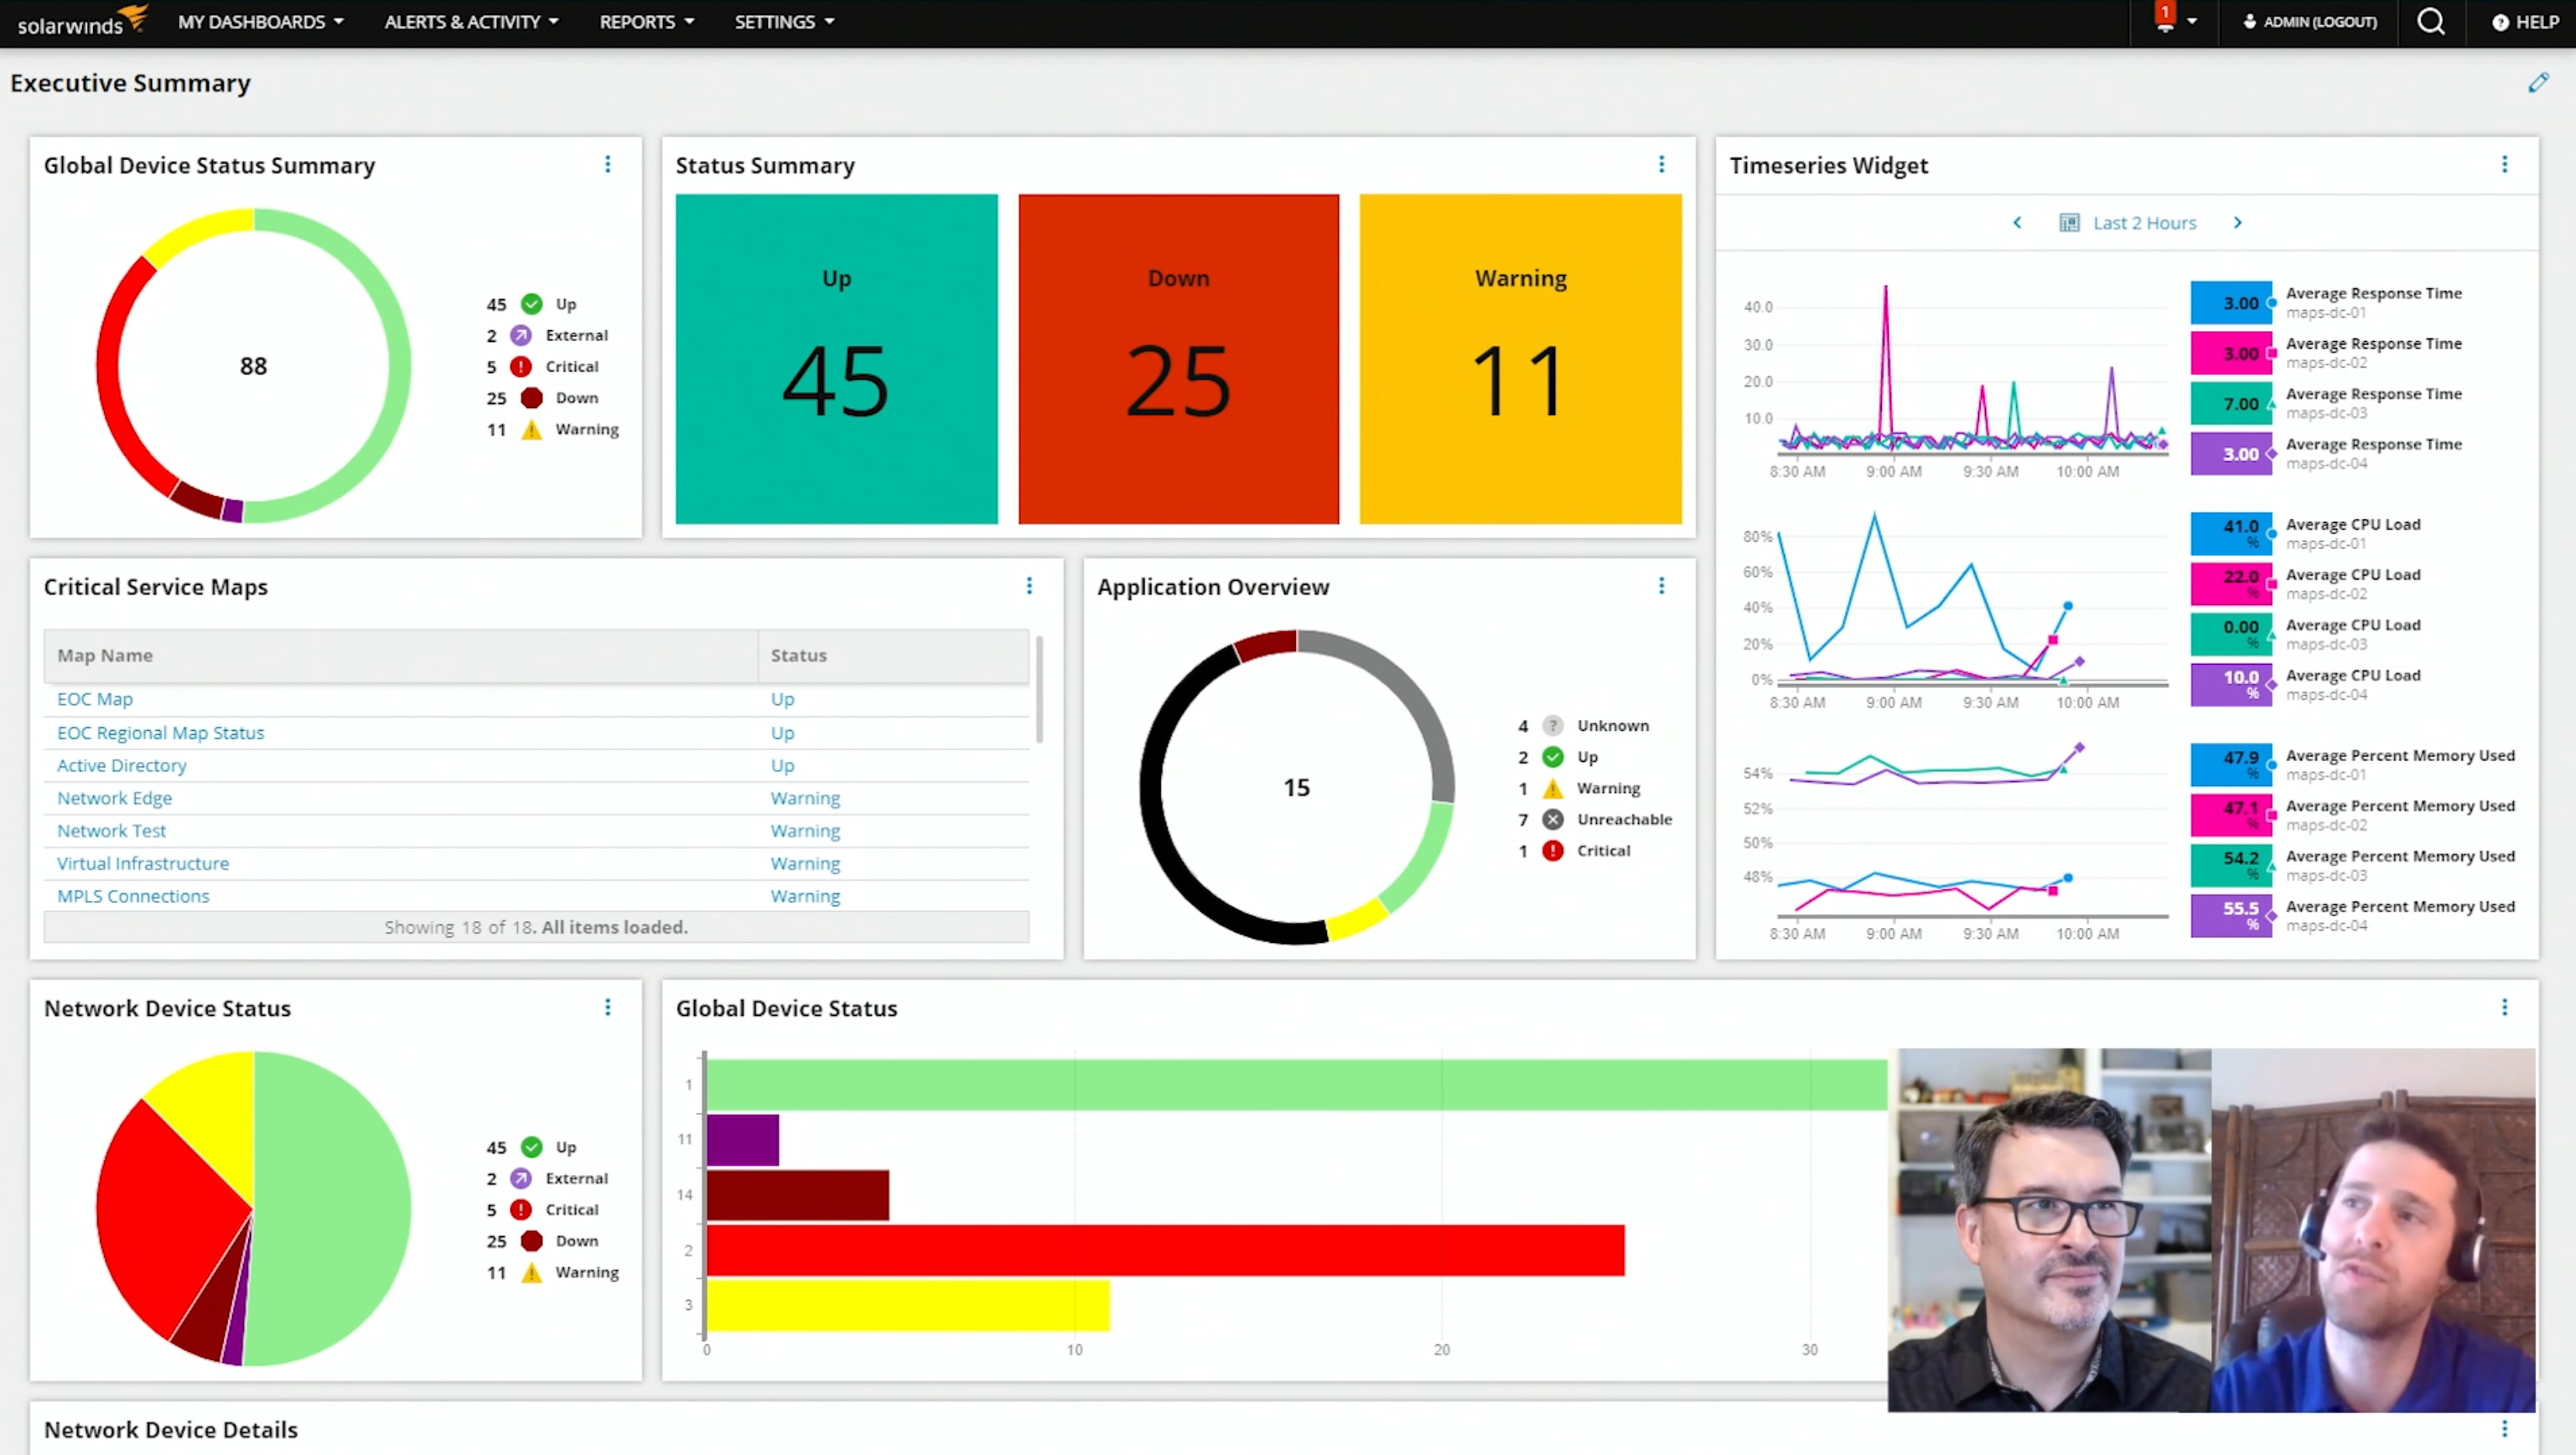
Fuente de la imagen: solarwinds.com
Características clave
- Mapeo de dependencias de aplicaciones: Visualiza las relaciones entre aplicaciones y componentes de infraestructura. Mejora el análisis de la causa raíz.
- Monitoreo de servidores y bases de datos: Rastrea el rendimiento de la CPU, la memoria y las consultas de bases de datos. Admite la detección proactiva de problemas.
- Paneles de rendimiento personalizables: Permiten a los equipos adaptar las vistas de monitoreo para diferentes partes interesadas.
- Flujos de trabajo de alertas y escalamiento: Automatiza las alertas basadas en condiciones de umbral. Mejora los tiempos de respuesta.
Ventajas
- Sólida visibilidad de la infraestructura: Ideal para organizaciones con sistemas locales de gran carga.
- Opciones de implementación flexibles: Compatible con entornos de TI híbridos.
- Métricas de rendimiento detalladas: Ofrece información granular a nivel de servidor.
Contras
- Menor enfoque en la nube nativa: No está tan optimizado para microservicios en contenedores.
- Esfuerzo de configuración manual: Requiere ajustes para entornos complejos.
Precios
- Plantilla de SolarWinds Observability Self-Hosted: Precio de $7.42/nodo/mes (facturado anualmente).
- Plantilla de Network Performance Monitor (NPM): Precio a partir de $1,638.
- Plantilla de Server & Application Monitor (SAM): Precio a partir de $2,440 (licencia única).
- Plantilla de Infrastructure Observability (SaaS): Precio de $180/nodo/año (aproximadamente $15/mes).
7. ManageEngine Applications Manager: suite de monitoreo enfocada en SMB
ManageEngine Applications Manager ofrece monitoreo asequible para pequeñas y medianas empresas. Proporciona visibilidad en aplicaciones, servidores y bases de datos. La plataforma admite implementaciones tanto en la nube como en las instalaciones. Muchas PyMEs lo adoptan por su equilibrio entre costo y funcionalidad. Ofrece información sobre el rendimiento sin la complejidad de nivel empresarial.
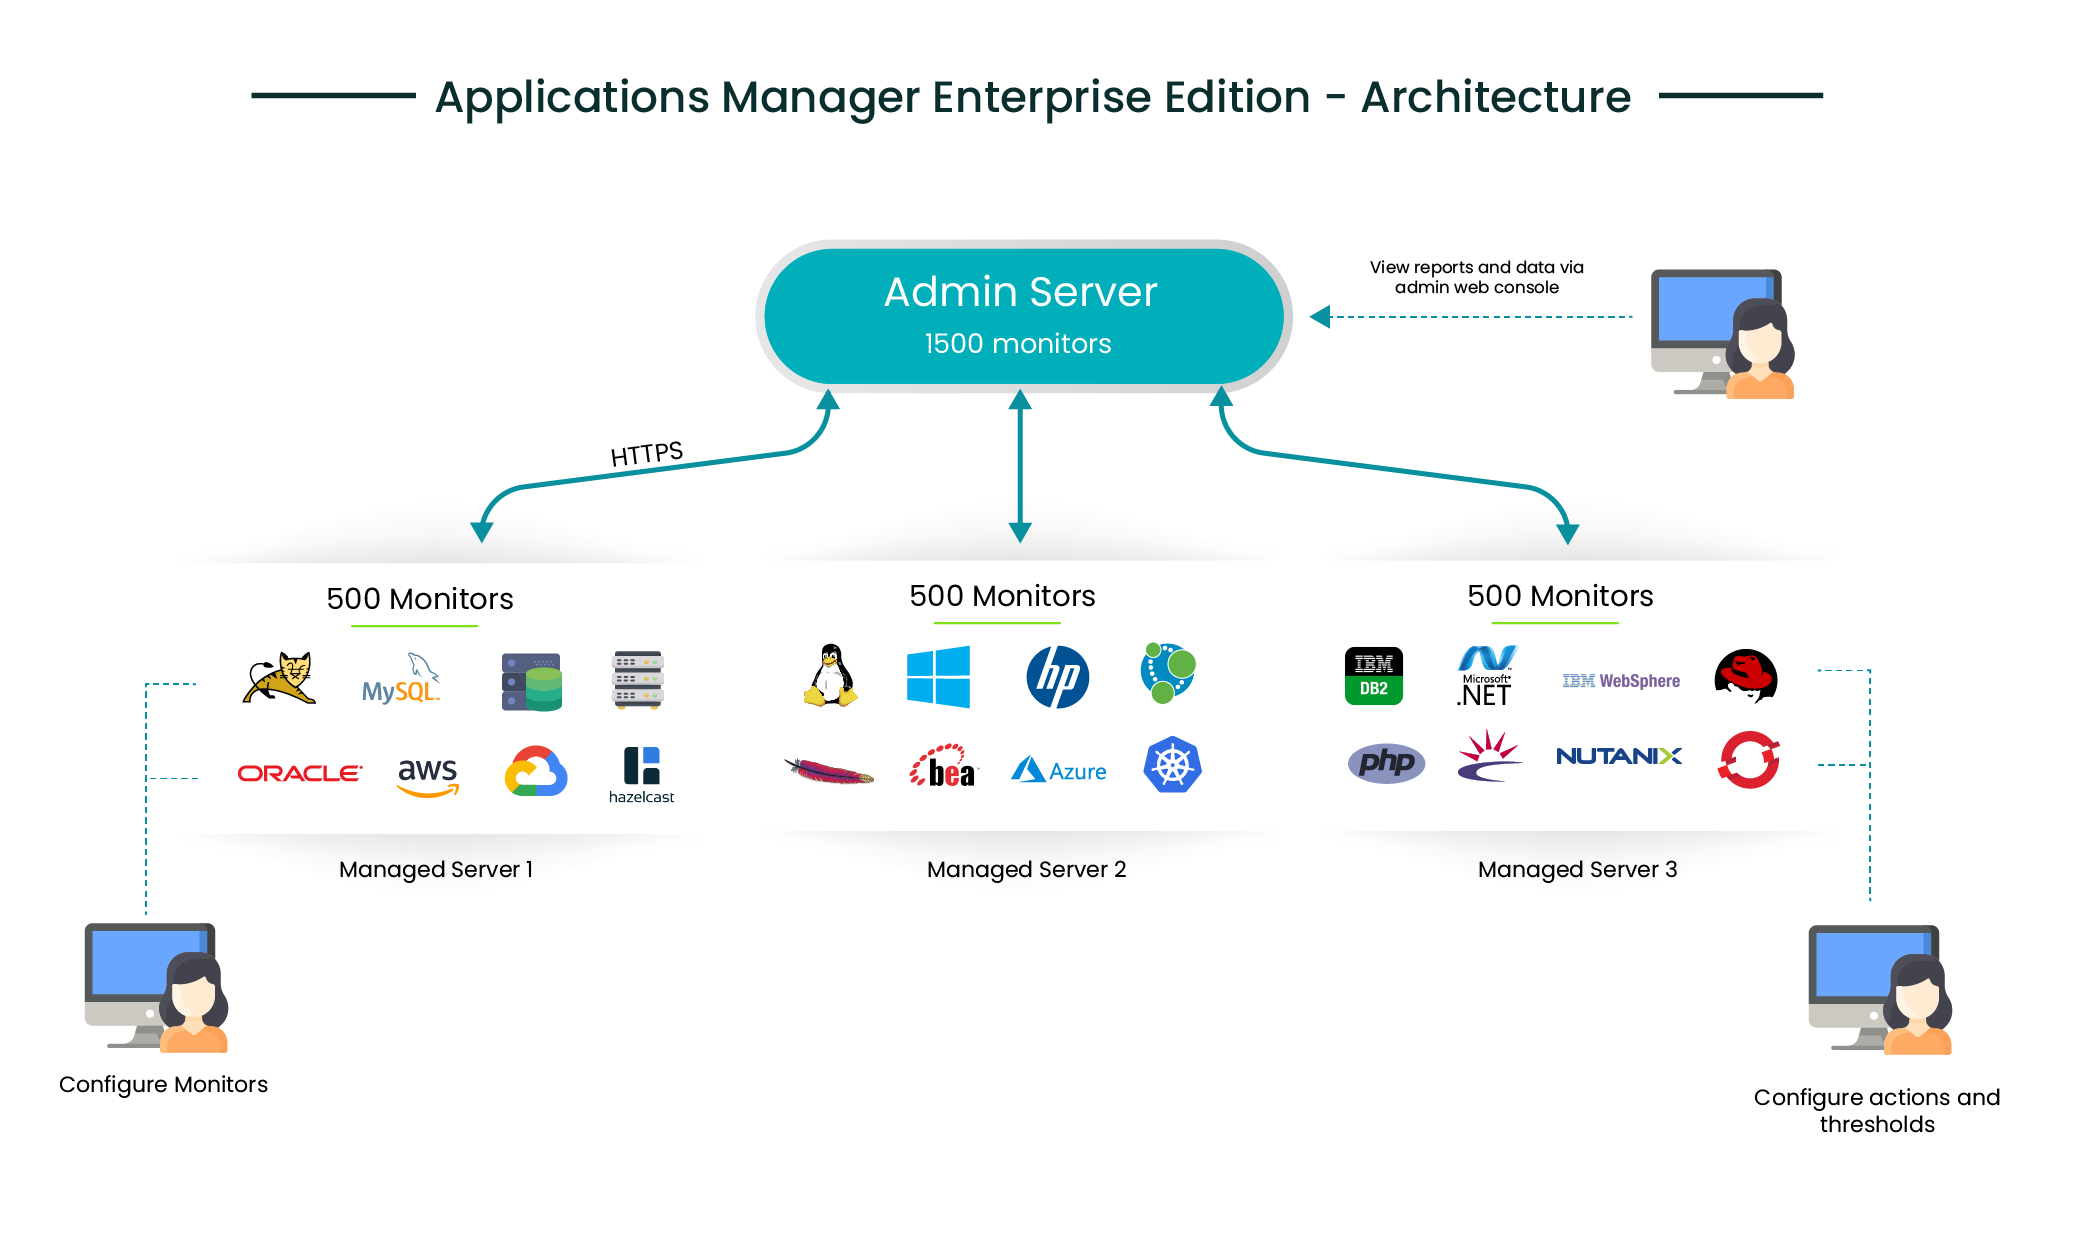
Fuente de la imagen: manageengine.com
Características clave
- Seguimiento del rendimiento de aplicaciones: Monitorea los tiempos de respuesta y el estado de las transacciones. Ayuda a mantener el tiempo de actividad.
- Herramientas de monitoreo de bases de datos: Realiza un seguimiento de las métricas de rendimiento de la base de datos y de las consultas lentas.
- Soporte de monitoreo de infraestructura: Cubre servidores, máquinas virtuales y recursos en la nube.
- Alertas y reportes automatizados: Envía notificaciones y resúmenes de rendimiento de forma automática.
Ventajas
- Asequible para PYMEs: Precios competitivos en comparación con herramientas APM empresariales.
- Cobertura amplia de monitoreo: Cubre tanto la infraestructura como las aplicaciones.
- Implementación sencilla: Adecuada para equipos de TI más pequeños.
Contras
- Capacidades avanzadas de IA limitadas: Menos funciones de automatización en comparación con las herramientas empresariales.
- Limitaciones de escalabilidad: Puede requerir actualizaciones para entornos muy grandes.
Precios
- Precios empresariales: Precios personalizados disponibles mediante consulta con el proveedor.
8. Splunk Observability: Inteligencia de rendimiento basada en datos
Splunk Observability combina monitoreo, registro y análisis en una plataforma de datos unificada. Está diseñada para organizaciones que gestionan datos de telemetría de gran volumen. Splunk admite análisis en tiempo real y flujos de trabajo de resolución de problemas en profundidad. Las empresas lo utilizan para la observabilidad en entornos nativos de la nube. La plataforma es altamente escalable para implementaciones de gran tamaño.
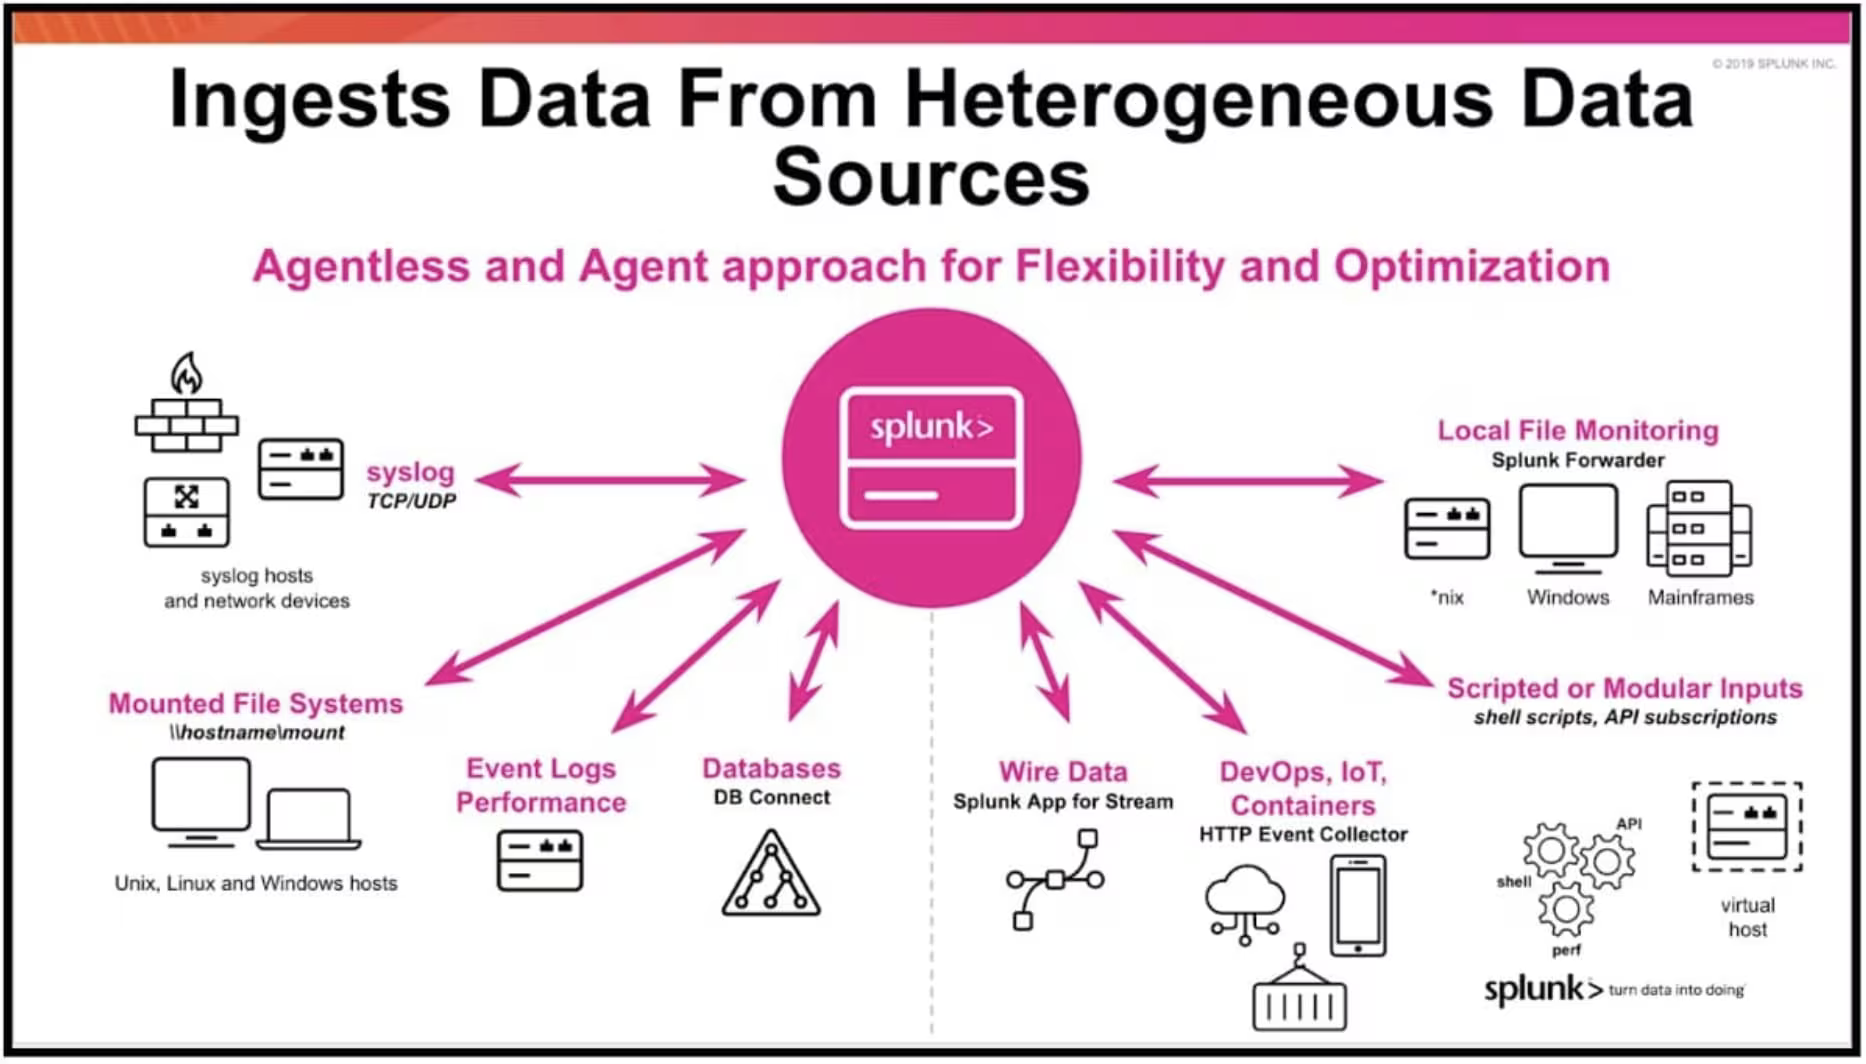
Fuente de la imagen: splunk.com
Características clave
- Motor de análisis de datos en tiempo real: Procesa grandes volúmenes de telemetría para obtener información rápida.
- Compatibilidad con rastreo distribuido: Rastrea transacciones a través de microservicios.
- Reglas avanzadas de alertas: Admite configuraciones sofisticadas de detección de anomalías.
- Plataforma unificada de observabilidad: Combina registros, métricas y rastreos en una sola interfaz.
Ventajas
- Arquitectura altamente escalable: Adecuada para cargas de trabajo de nivel empresarial.
- Capacidades sólidas de análisis: Admite flujos de trabajo detallados para la resolución de problemas.
- Visibilidad integral de datos: Cubre sistemas distribuidos complejos.
Contras
- Modelo de precios premium: Puede resultar costoso para equipos pequeños.
- Implementación compleja: Requiere experiencia para su optimización.
Precios
- Precios para empresas: Precios personalizados disponibles mediante consulta con el proveedor.
9. Elastic APM: solución de monitoreo de aplicaciones de código abierto
Elastic APM forma parte de Elastic Stack y ofrece capacidades de monitoreo de código abierto. Se integra con Elasticsearch y Kibana para la visualización de datos. Los equipos que utilizan Elastic suelen adoptar Elastic APM para lograr una integración coherente dentro del ecosistema. Es popular entre las organizaciones que buscan flexibilidad de código abierto. La plataforma admite implementaciones autogestionadas y en la nube.
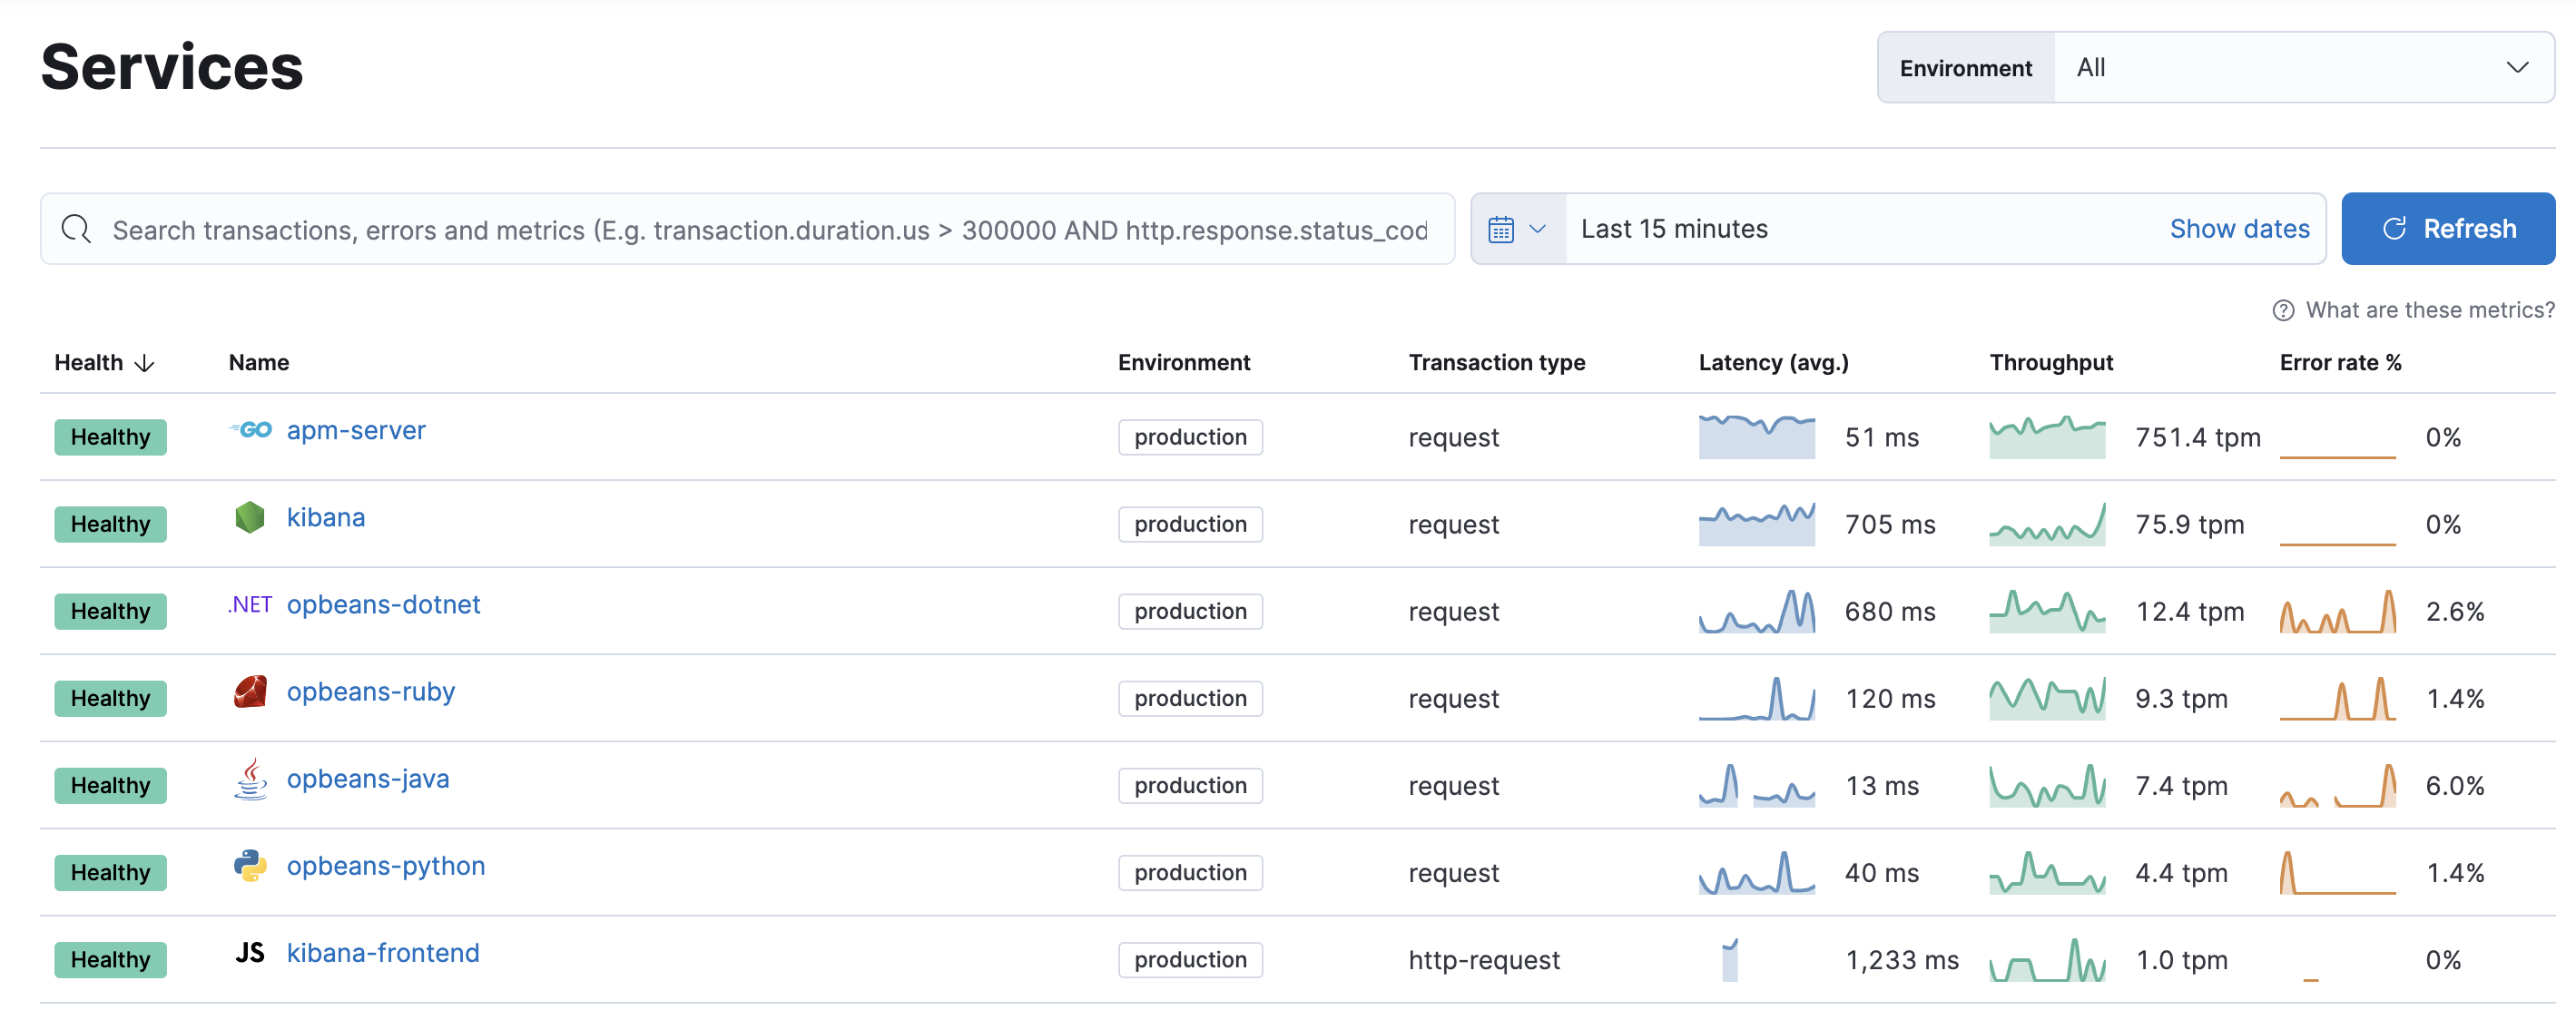
Fuente de la imagen: elastic.co
Características clave
- Motor de rastreo de código abierto: Proporciona rastreo distribuido para aplicaciones.
- Integración con Elastic Stack: Funciona de manera fluida con Elasticsearch y los paneles de control de Kibana.
- Métricas de rendimiento en tiempo real: Monitorea la latencia, los errores y el rendimiento.
- Creación de paneles personalizados: Permite la visualización adaptada de los datos de rendimiento.
Ventajas
- Flexibilidad de código abierto: Adecuado para organizaciones con conciencia de costos.
- Alta compatibilidad con el ecosistema: Se integra con las herramientas de Elastic.
- Opción de implementación autogestionada: Ofrece control sobre la infraestructura.
Contras
- Requiere conocimientos técnicos: La configuración y optimización necesitan habilidades de ingeniería.
- Automatización integrada limitada: Menos remediación impulsada por IA en comparación con las herramientas empresariales.
Precios
- Plantilla de plan gratuito / básico: Precio de $0/mes
- Plantilla de plan estándar: Precio aproximado de $95/mes (en Elastic Cloud)
- Plantilla de plan platino: Precio aproximado de $109/mes (tarifa inicial en Elastic Cloud).
- Plantilla del plan empresarial: Con un precio aproximado de $125/mes (tarifa inicial en Elastic Cloud).
10. Instana: Descubrimiento y rastreo automatizado de aplicaciones
Instana se enfoca en el descubrimiento automatizado y el rastreo en tiempo real para entornos de microservicios. Detecta automáticamente servicios y dependencias sin configuración manual. Las organizaciones que gestionan Kubernetes y cargas de trabajo en contenedores adoptan con frecuencia Instana. La plataforma enfatiza la automatización y el análisis rápido de la causa raíz. Está diseñada para equipos modernos de DevOps.
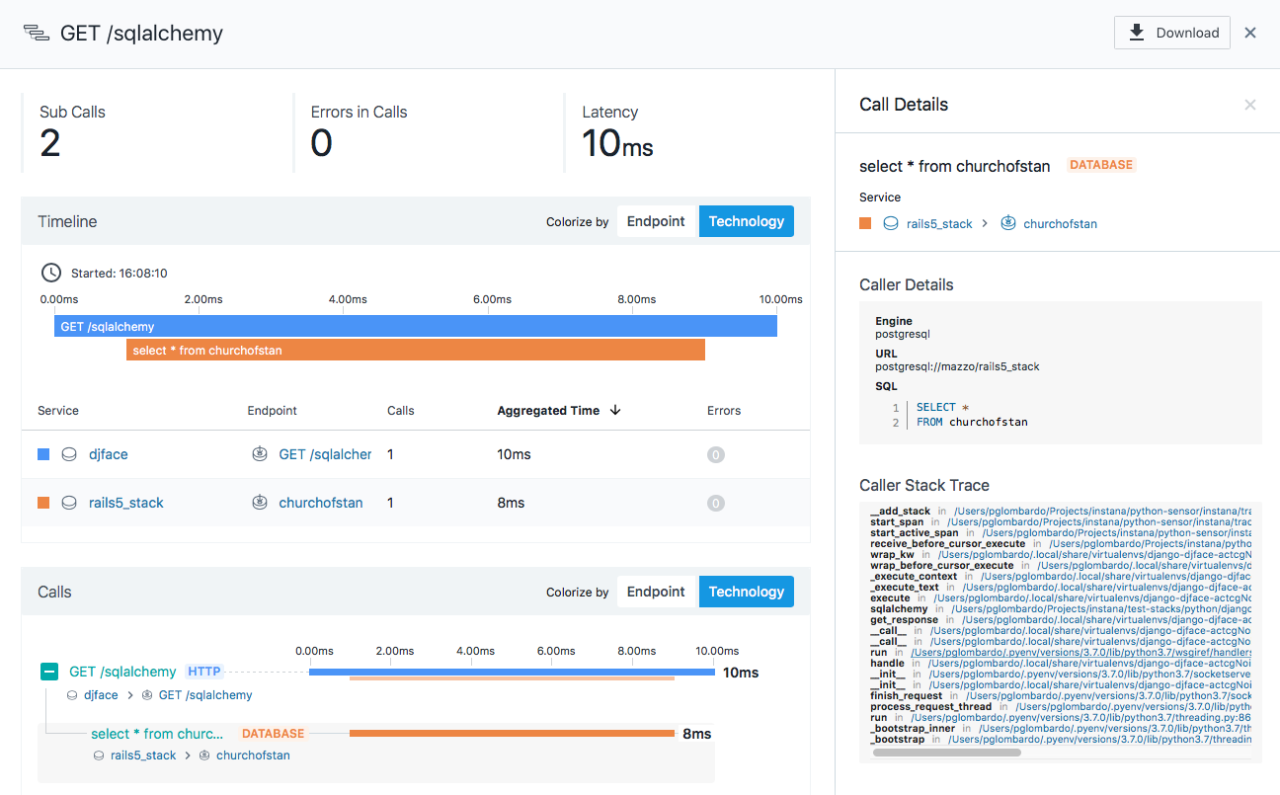
Fuente de la imagen: ibm.com
Características clave
- Detección automática de servicios: Detecta y mapea servicios de manera dinámica. Reduce el esfuerzo de configuración manual.
- Motor de rastreo en tiempo real: Proporciona visibilidad inmediata del rendimiento a través de los servicios.
- Análisis contextual de incidentes: Identifica las causas raíz rápidamente.
- Monitoreo nativo de Kubernetes: Optimizado para entornos con contenedores.
Ventajas
- Fuertes capacidades de automatización: Reducen la configuración manual.
- Diseño compatible con microservicios: Ideal para implementaciones nativas en la nube.
- Detección rápida de la causa raíz: Mejora la velocidad de resolución de problemas.
Contras
- Precios enfocados en empresas: Puede exceder el presupuesto de las PyMEs.
- Requisitos avanzados de configuración: Necesita una adecuada incorporación.
Precios
- Plantilla del plan Observability Essentials: Precio de $21.20/MVS/mes.
- Plantilla del plan Observability Standard: Precio de $79.50/MVS/mes.
11. LogicMonitor: Plataforma de monitoreo de infraestructura híbrida
LogicMonitor ofrece monitoreo híbrido para infraestructura local y en la nube. Admite descubrimiento automatizado y análisis de rendimiento. Las organizaciones que gestionan entornos de TI mixtos suelen elegir LogicMonitor. La plataforma enfatiza la escalabilidad y la automatización. Es muy adecuada para proveedores de servicios administrados.
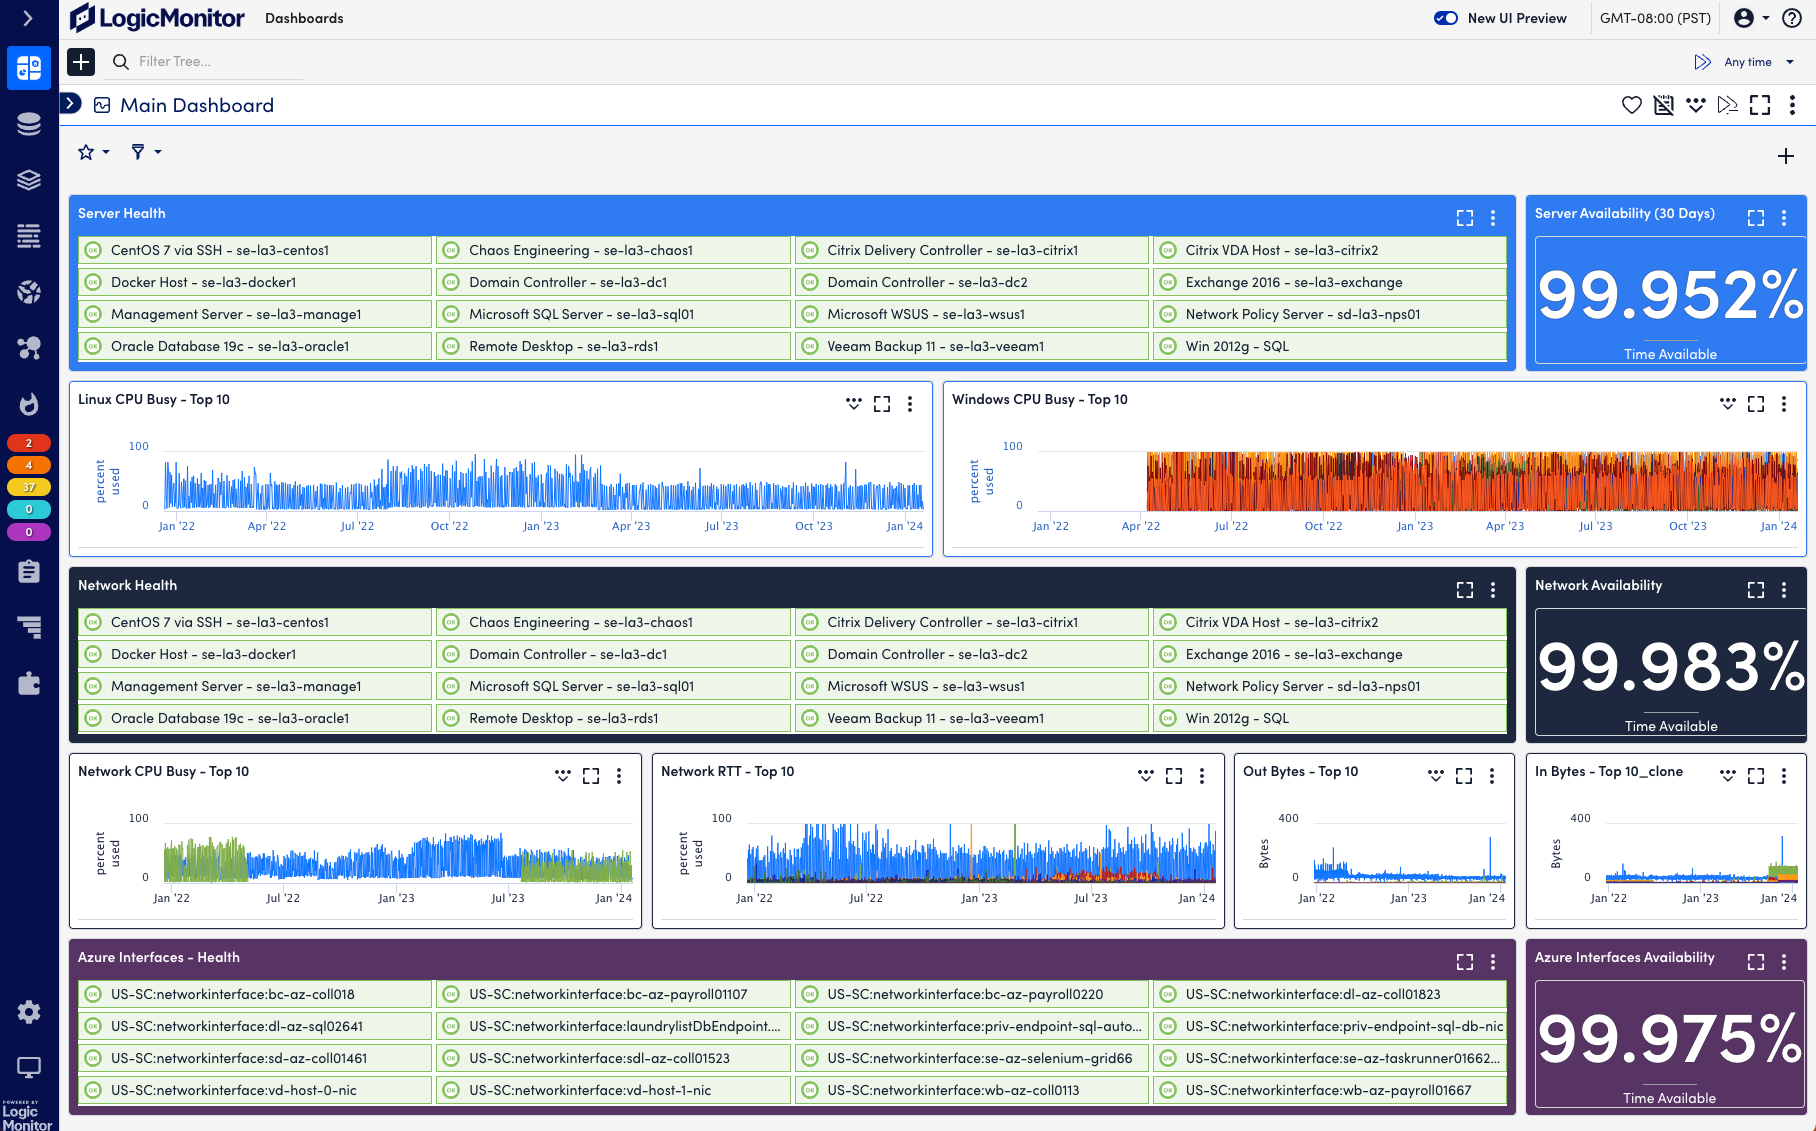
Fuente de la imagen: logicmonitor.com
Características clave
- Cobertura de monitoreo híbrido: Compatible con sistemas en la nube y locales.
- Detección automática de dispositivos: Detecta dinámicamente los componentes de la infraestructura.
- Configuraciones personalizadas de alertas: Compatible con flujos de trabajo de notificación flexibles.
- Análisis de tendencias de rendimiento: Proporciona visibilidad a largo plazo sobre la salud del sistema.
Ventajas
- Sólido soporte para entornos híbridos: Ideal para entornos de TI en transición.
- Arquitectura escalable: Maneja las necesidades crecientes de infraestructura.
- Monitoreo impulsado por automatización: Reduce la configuración manual.
Contras
- Menor profundidad en el rastreo a nivel de aplicación: Más fuerte en visibilidad de infraestructura.
- Costo de suscripción: El precio puede aumentar según el tamaño del entorno.
Precios
- Plantilla del plan Essentials: Precio de $16/unidad híbrida/mes.
- Plantilla del plan Advanced: Precio de $27/unidad híbrida/mes.
- Plantilla del plan Signature + Edwin AI: Precio de $53/unidad híbrida/mes.
12. Sentry: herramienta de monitoreo de errores orientada al desarrollador
Sentry se enfoca en el seguimiento de errores y la depuración para desarrolladores. Proporciona visibilidad detallada sobre fallos y excepciones de aplicaciones. Los equipos de ingeniería adoptan Sentry para identificar errores desde las primeras etapas del desarrollo. La plataforma es compatible con múltiples lenguajes de programación y frameworks. Es ampliamente utilizada en entornos de startups y empresas medianas.
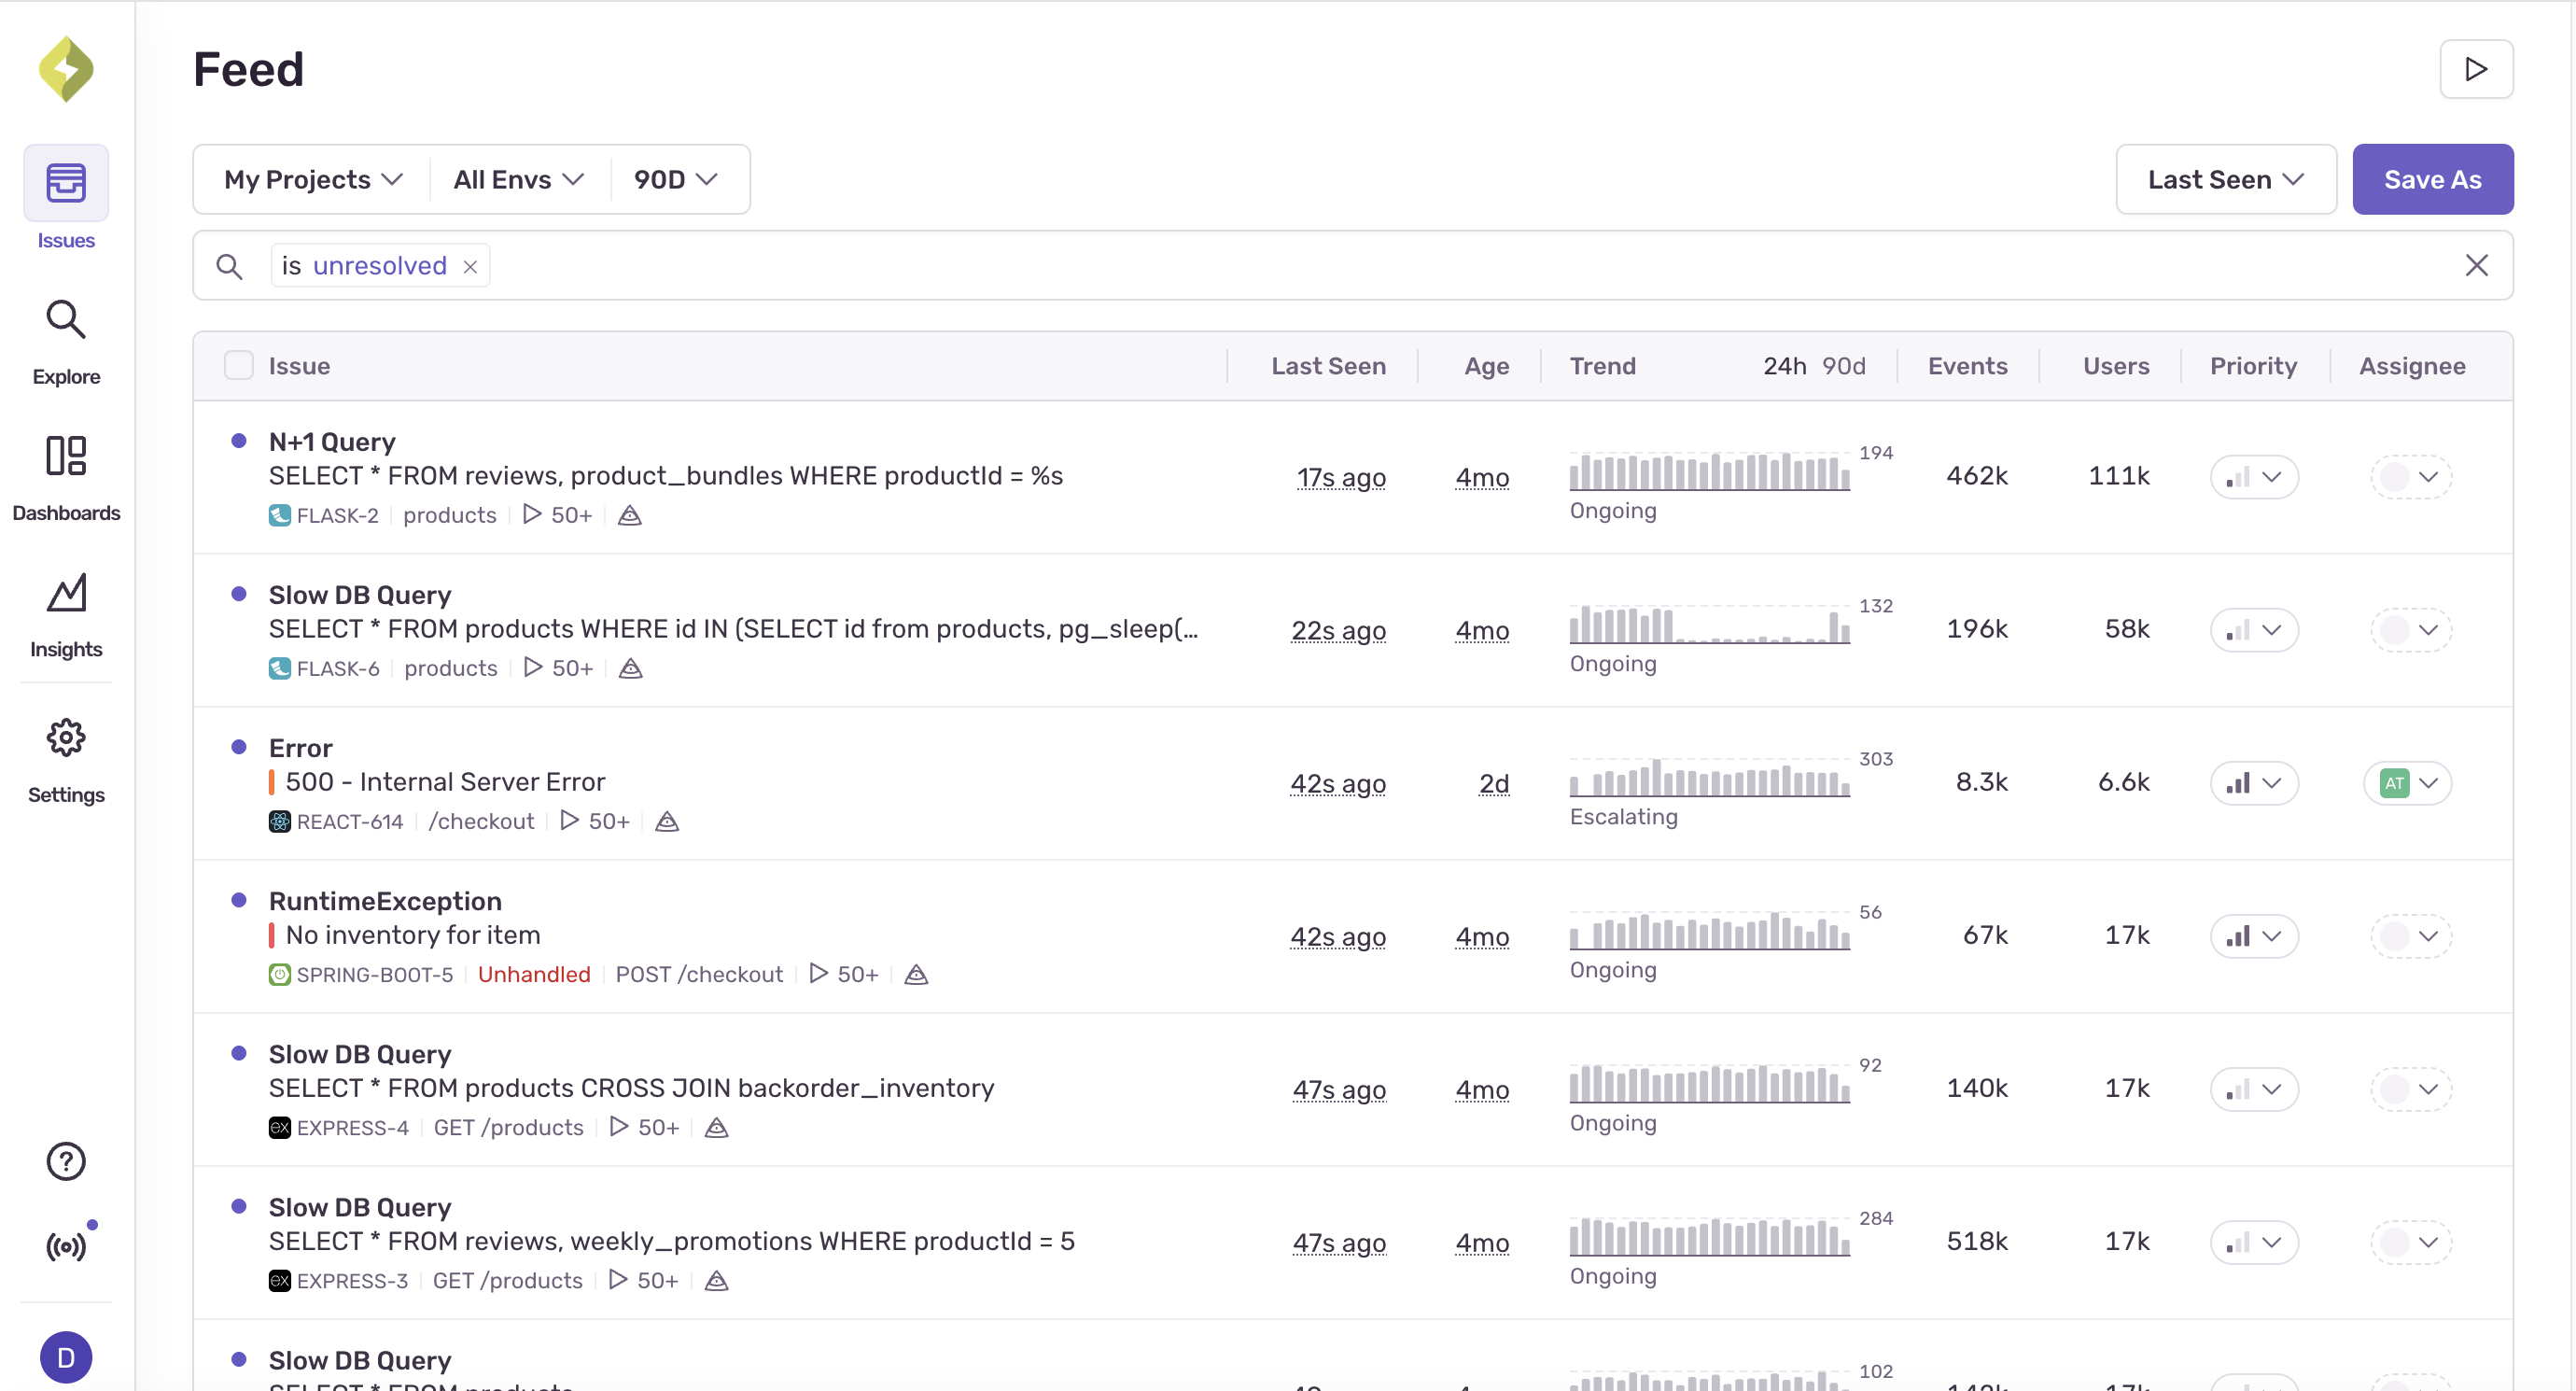
Fuente de la imagen: sentry.io
Características clave
- Seguimiento de errores en tiempo real: Captura fallos y excepciones de aplicaciones de manera instantánea.
- Visibilidad de la traza de pila: Proporciona información detallada para la depuración.
- Soporte de seguimiento de versiones: Vincula errores con implementaciones específicas.
- Integración con el flujo de trabajo del desarrollador: Se conecta con pipelines de CI/CD.
Ventajas
- Diseño centrado en el desarrollador: Fácil integración en los flujos de trabajo de ingeniería.
- Precios iniciales asequibles: Accesible para startups.
- Configuración rápida: Requiere una configuración mínima.
Contras
- Monitoreo de infraestructura limitado: Se enfoca principalmente en errores de aplicaciones.
- No es una plataforma completa de observabilidad: Requiere herramientas complementarias.
Precios
- Plantilla del plan para desarrolladores: Precio de $0.
- Plantilla del plan para equipos: Precio de $26/mes (facturado anualmente).
- Plantilla del plan empresarial: Con un precio de $80/mes (facturado anualmente).
- Plantilla del plan corporativo: El precio se proporciona mediante cotizaciones personalizadas.
13. Honeycomb: Plataforma de observabilidad impulsada por eventos
Honeycomb se especializa en la observabilidad basada en eventos para sistemas complejos. Permite una depuración profunda de entornos distribuidos. Los equipos de ingeniería utilizan Honeycomb para análisis en tiempo real y depuración exploratoria. La plataforma admite análisis de datos de alta cardinalidad. Está diseñada para equipos avanzados de DevOps.
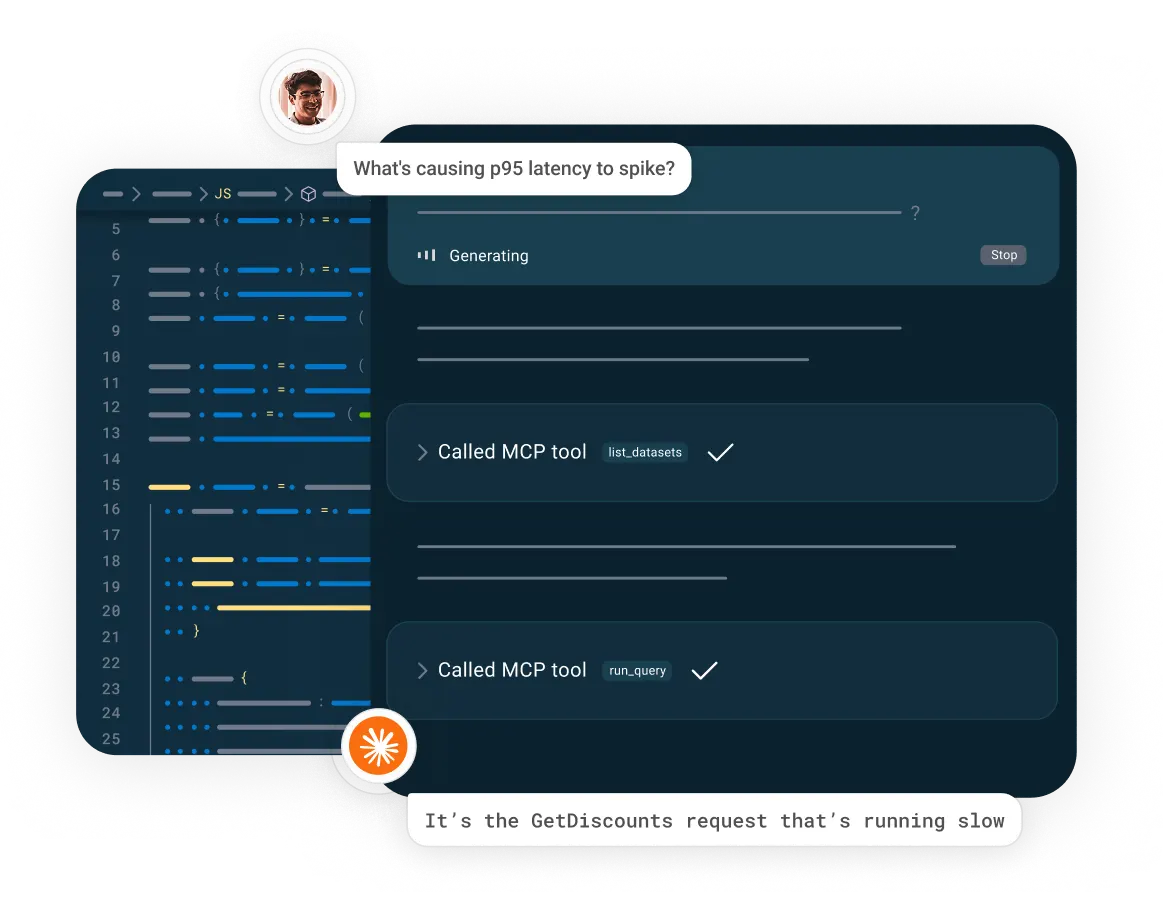
Fuente de la imagen: honeycomb.io
Características clave
- Motor de análisis basado en eventos: Permite una investigación detallada del rendimiento.
- Compatibilidad con alta cardinalidad: Maneja telemetría detallada sin pérdida de agregación.
- Capacidades de consulta en tiempo real: Admite flujos de trabajo de depuración exploratoria.
- Integración de rastreo distribuido: Mejora la visibilidad de los microservicios.
Ventajas
- Herramientas de depuración potentes: Ideales para arquitecturas complejas.
- Capacidades flexibles de consulta: Compatible con análisis exploratorio.
- Alineación moderna con DevOps: Diseñado para equipos nativos de la nube.
Contras
- Requisito técnico avanzado: Más adecuado para equipos con experiencia.
- Nivel de precios premium: Costos a nivel empresarial.
Precios
- Plantilla del plan gratuito: Precio de $0/mes.
- Plantilla del plan Pro: Precio de $130/mes (facturado anualmente).
- Plantilla del plan Enterprise: El precio se proporciona mediante cotizaciones personalizadas.
14. Raygun: herramienta de monitoreo de usuarios reales y reporte de fallos
Raygun se enfoca en el monitoreo real de usuarios y el análisis de fallos. Ayuda a las organizaciones a mejorar la experiencia digital mediante visibilidad del rendimiento del lado del cliente. La plataforma es adecuada para aplicaciones web y móviles. Los equipos utilizan Raygun para reducir errores visibles para el usuario y cuellos de botella en el rendimiento. Combina reportes de fallos con información sobre el rendimiento.
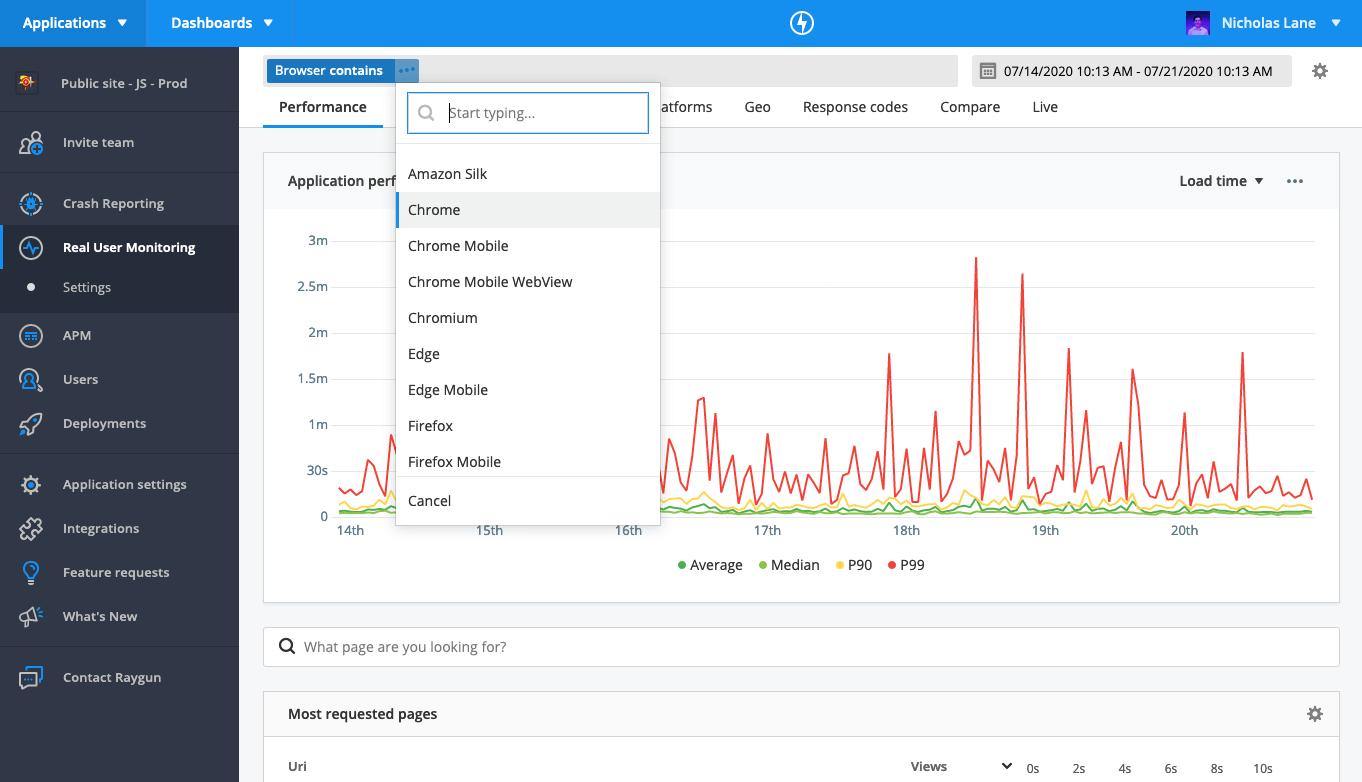
Fuente de la imagen: raygun.com
Características clave
- Herramientas de monitoreo de usuarios reales: Rastrea métricas de rendimiento del front-end.
- Motor de análisis de fallos: Identifica errores y fallos recurrentes.
- Información sobre el impacto en el rendimiento: Resalta problemas que afectan directamente a los usuarios.
- Soporte de monitoreo multiplataforma: Cubre aplicaciones web y móviles.
Ventajas
- Enfoque sólido en la experiencia del usuario: Prioriza la optimización del rendimiento del front-end.
- Paneles de informes claros: Simplifica la visibilidad del rendimiento.
- Integración amigable para desarrolladores: Configuración sencilla.
Desventajas
- Profundidad limitada de monitoreo de infraestructura: Enfocado principalmente en datos del lado del usuario.
- No es observabilidad de pila completa: Requiere herramientas de monitoreo complementarias.
Precios
- Plantilla del plan estándar de APM: Precio de $80/mes/100,000 trazas.
- Plantilla del plan empresarial de APM: Precio desde $600/mes.
- Plantilla del plan empresarial de APM: El precio se proporciona mediante cotizaciones personalizadas.
15. Stackify Retrace: Software de monitoreo de rendimiento a nivel de código
Stackify Retrace se enfoca en la supervisión y resolución de problemas centrada en los desarrolladores. Proporciona visibilidad a nivel de código sobre el rendimiento de las aplicaciones. Los equipos de desarrollo lo utilizan para diagnosticar cuellos de botella de forma temprana. La plataforma admite la gestión de registros y el análisis de rendimiento. Está diseñada para mejorar la calidad del software durante los ciclos de desarrollo.
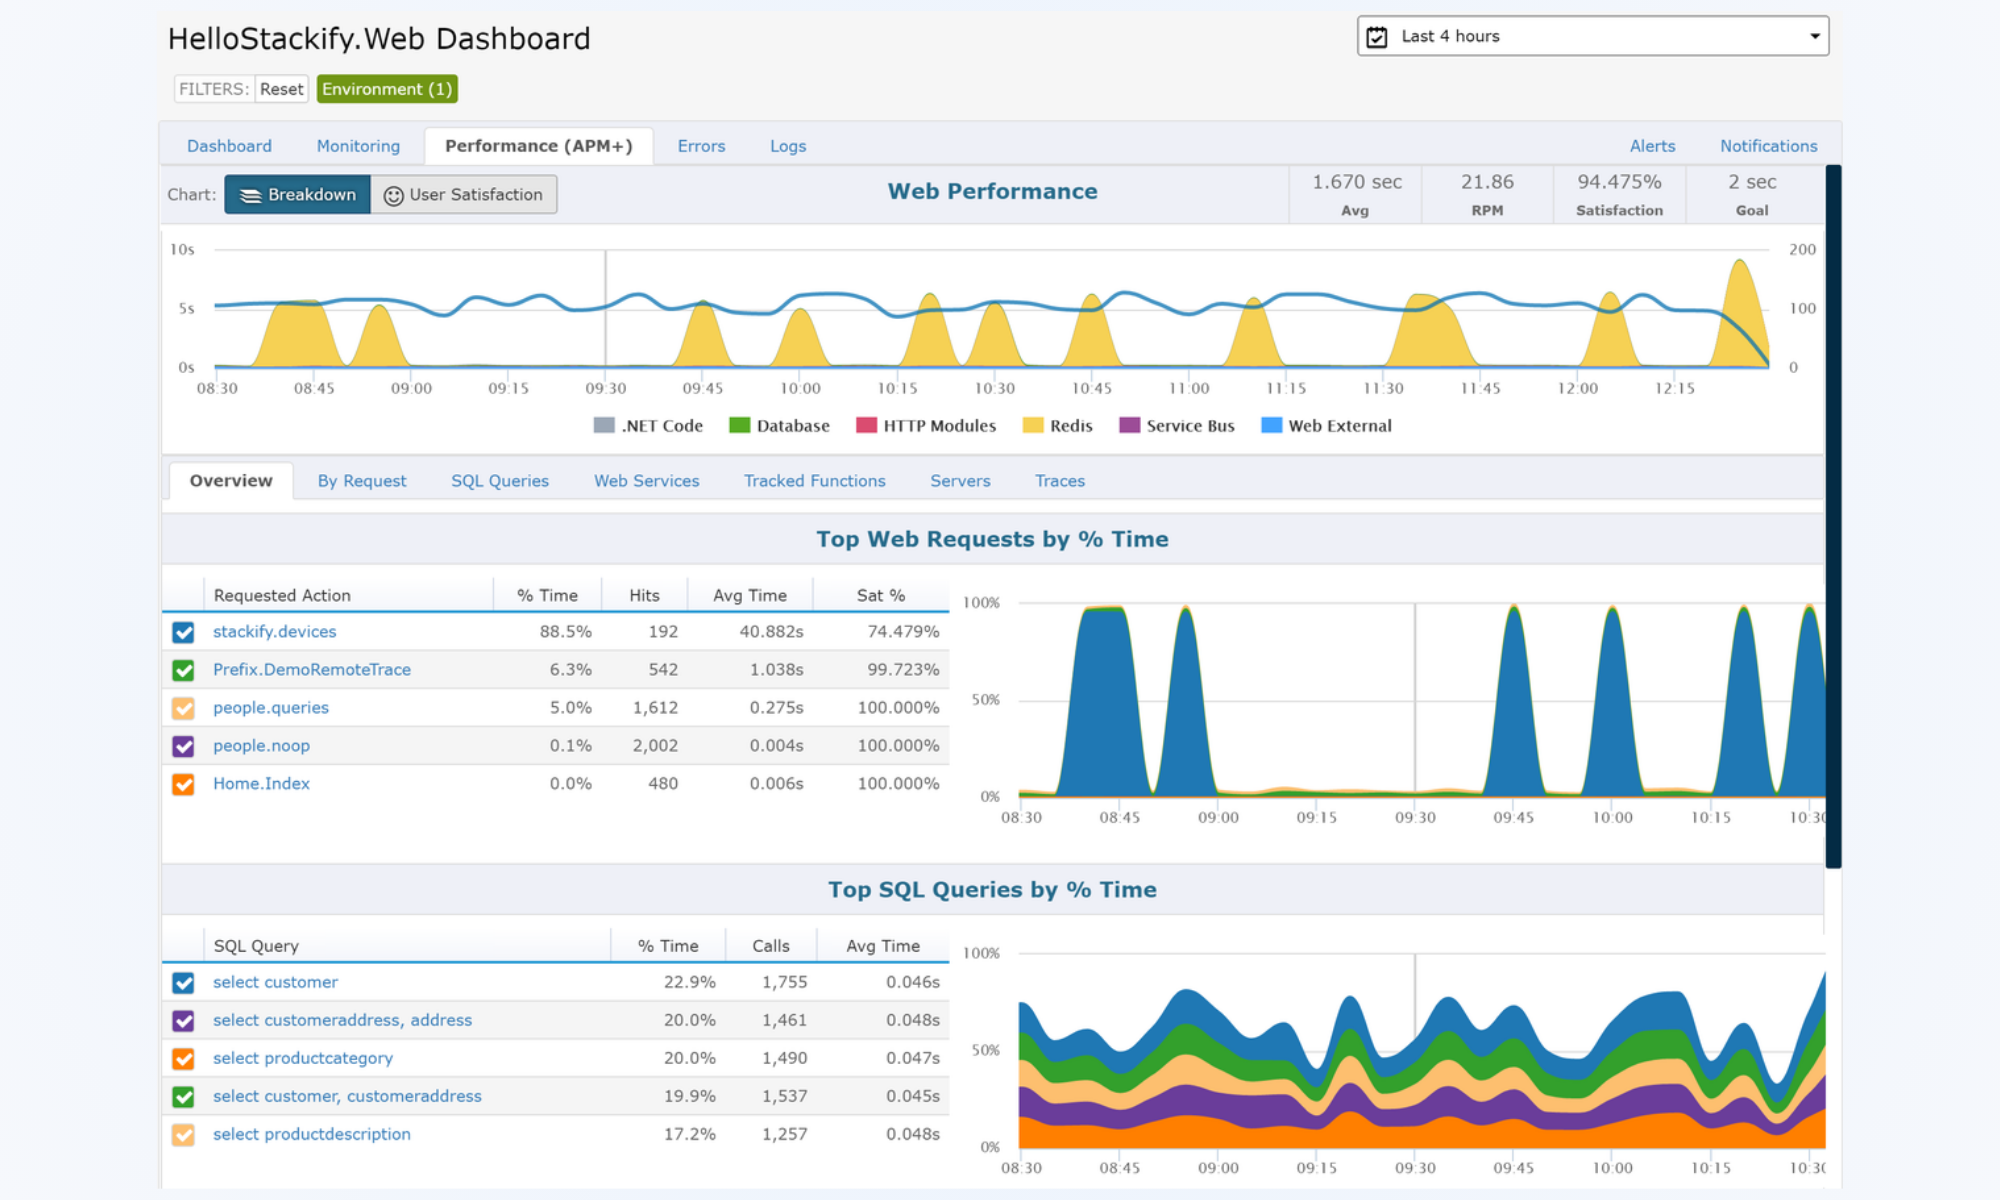
Fuente de la imagen: stackify.com
Características clave
- Rastreo de rendimiento a nivel de código: Identifica cuellos de botella en el código de la aplicación.
- Gestión de registros integrada: Centraliza los registros para la resolución de problemas.
- Soporte para seguimiento de implementaciones: Vincula los cambios de rendimiento con las versiones.
- Integración de monitoreo de errores: Captura excepciones y problemas en tiempo de ejecución.
Ventajas
- Visibilidad enfocada en desarrolladores: Mejora la eficiencia de depuración.
- Soporte de registro integrado: Simplifica los flujos de trabajo de resolución de problemas.
- Opción asequible para el mercado medio: Adecuada para equipos en crecimiento.
Contras
- Menor profundidad de IA empresarial: Menos funciones de automatización.
- Monitoreo limitado de infraestructura híbrida: Enfocado en la capa de aplicación.
Precios
- Plantilla de monitoreo de rendimiento de la aplicación Retrace: Precio desde $80/nodo/mes.
Tendencias emergentes en el software de gestión del rendimiento de aplicaciones
El monitoreo del rendimiento de aplicaciones continúa evolucionando a medida que las arquitecturas nativas de la nube y los sistemas distribuidos se vuelven más complejos. Las organizaciones están ampliando el uso de herramientas de gestión del rendimiento de software para conectar la observabilidad, la automatización y los flujos de trabajo de remediación entre equipos. Las siguientes tendencias destacan la dirección de las plataformas modernas de APM.
- Remediación impulsada por AIOps: La inteligencia artificial se utiliza cada vez más para detectar anomalías y activar flujos de trabajo de remediación automatizados. Esto reduce la resolución manual de problemas y acelera la resolución de incidentes. Las respuestas automatizadas ayudan a los equipos a mantener el tiempo de actividad a gran escala.
- Convergencia de observabilidad: Las herramientas de monitoreo, registro y rastreo se están fusionando en plataformas unificadas de observabilidad. Esta tendencia mejora la visibilidad en toda la pila tecnológica. La observabilidad unificada ayuda a los equipos a diagnosticar problemas más rápido y reducir la proliferación de herramientas.
- Análisis de costo-rendimiento: Las organizaciones ahora se enfocan en vincular las métricas de rendimiento con los costos de infraestructura. Las herramientas de APM ofrecen cada vez más información sobre oportunidades de optimización de costos. Esto ayuda a los equipos a equilibrar las mejoras de rendimiento con las limitaciones presupuestarias.
- Flujos de trabajo de automatización SRE: Las prácticas de ingeniería de confiabilidad de sitios continúan influyendo en las herramientas de monitoreo. La automatización ayuda a los equipos a hacer cumplir los objetivos de nivel de servicio y mejorar la confiabilidad. Las soluciones modernas de APM cada vez más admiten flujos de trabajo SRE y la gestión de incidentes.
- Pruebas de rendimiento adelantadas: La supervisión del rendimiento se está trasladando a etapas más tempranas del ciclo de desarrollo. Ahora los equipos prueban el rendimiento durante el desarrollo y la fase de pruebas previas, en lugar de hacerlo después del despliegue. Esto reduce los incidentes en producción y mejora la calidad de las versiones.
Conclusión
Las herramientas de gestión del rendimiento de aplicaciones se han vuelto esenciales para mantener la confiabilidad en entornos digitales complejos. Las organizaciones deben seleccionar software de monitoreo de rendimiento de aplicaciones que ofrezca visibilidad, automatización y colaboración entre equipos. Las herramientas modernas conectan las percepciones del monitoreo con los flujos de trabajo para acelerar la respuesta a incidentes y mejorar la experiencia del usuario.
Plataformas como Lark demuestran cómo las percepciones del monitoreo pueden traducirse en acciones coordinadas entre equipos. De cara al futuro, seleccionar la solución APM adecuada será fundamental para mantener el rendimiento, reducir el tiempo de inactividad y ofrecer experiencias digitales consistentes.
Preguntas frecuentes
¿Qué son APM y TPM?
APM se refiere a la gestión del rendimiento de aplicaciones, que se enfoca en monitorear la salud, la confiabilidad y la experiencia del usuario de las aplicaciones. TPM normalmente se refiere al monitoreo del rendimiento de transacciones, que rastrea transacciones individuales a través de los sistemas. Juntos, proporcionan visibilidad completa del rendimiento en toda la pila. Plataformas como Lark ayudan a los equipos a conectar estos conocimientos con la respuesta a incidentes y la coordinación entre equipos.
¿Qué papel desempeña la IA en los sistemas modernos de gestión del rendimiento de aplicaciones?
La IA ayuda a detectar anomalías, predecir interrupciones y automatizar el análisis de la causa raíz. Reduce el trabajo de monitoreo manual y acelera la resolución de problemas. Muchas plataformas ahora utilizan IA para recomendar acciones de remediación de forma automática. Los equipos pueden usar herramientas como Lark para coordinar las respuestas y dar seguimiento a las tareas posteriores.
¿Pueden las herramientas de gestión del rendimiento de aplicaciones reducir los costos de la infraestructura en la nube?
Sí, las herramientas APM identifican cargas de trabajo ineficientes, recursos sin uso y cuellos de botella de rendimiento. Esto ayuda a los equipos a optimizar el uso de la infraestructura y evitar gastos innecesarios. El análisis de costo-rendimiento se está convirtiendo en una característica clave de las plataformas modernas de monitoreo. Los equipos suelen usar plataformas de colaboración como Lark para convertir estos conocimientos en iniciativas de optimización de costos.
¿Cómo se comparan las herramientas APM de código abierto con las soluciones de nivel empresarial?
Las herramientas de código abierto ofrecen flexibilidad y menores costos de entrada, pero a menudo requieren más configuración y mantenimiento. Las herramientas empresariales suelen proporcionar IA avanzada, automatización y soporte. Muchas organizaciones combinan ambos enfoques según sus necesidades. Las plataformas de colaboración como Lark ayudan a los equipos a centralizar la información de monitoreo sin importar las herramientas utilizadas.
¿Qué KPIs debe monitorear semanalmente un administrador de rendimiento de aplicaciones?
Los KPI comunes incluyen el tiempo de respuesta, la tasa de errores, el tiempo de actividad, el rendimiento y la utilización de la infraestructura. El seguimiento de estas métricas ayuda a los equipos a identificar tendencias y prevenir incidentes. Las revisiones semanales aseguran que los objetivos de rendimiento permanezcan alineados con las expectativas del negocio. Los equipos pueden usar plataformas como Lark para compartir tableros y coordinar mejoras entre departamentos.
Lectura relacionada
Table of contents
¿Interesado en Lark?

Todas tus herramientas en un solo lugar
Ahorra tiempo y aumenta la eficiencia
Ahorra hasta un 70 % en costos de software
Table of contents
¿Interesado en Lark?
Todas tus herramientas en un solo lugar
Ahorra tiempo y aumenta la eficiencia
Ahorra hasta un 70 % en costos de software
Sigue leyendo

© 2026 Lark Technologies Pte. Ltd.